Az AWS bejelentette, hogy 2026. október 24-én, szombaton egy különleges gyakorlatot végez az AWS European Sovereign Cloud-on. A cél annak bemutatása, hogy a szolgáltatás az Európai Unión kívüli infrastruktúra nélkül is működni tud. A bejelentést Stéphane Israël, az AWS European Sovereign Cloud Managing Directora tette közzé még szeptember 28-án az AWS Security Blogon.
Most nézzük meg, mi fog történni, és mit nem közöl a bejelentés.
Mi lesz a gyakorlat lényege?
Több órán át az AWS European Sovereign Cloud nem csatlakozik az AWS Global Network backbone-hoz. A backbone az a privát hálózat, amely az AWS régiói között továbbítja a szükséges adatokat, a nyilvános internet használata nélkül. A gyakorlat alatt ez a forgalom biztonságosan a nyilvános interneten halad majd. A szolgáltatás ekkor kizárólag a saját, európai internetszolgáltatóktól származó dedikált internetkapcsolatát használja.
Normál működés közben az AWS European Sovereign Cloud két globális rendszert használ. Az egyik a backbone. A másik egy külön rendszer, amelyet a helyi EU-s csapat irányít és felügyel, és amely korlátozott, ellenőrzött adatátvitelt kezel. Ez a rendszer ellenőrzött forráskód-tükrözést és szoftverfrissítéseket fogad be, kifelé pedig csak nagyon kevés, jóváhagyott információt enged. A gyakorlat idejére ezt teljesen kikapcsolják.
Az AWS szerint egyik rendszer sem kritikus a működés szempontjából, és egyik sem érinti a szuverenitási vállalásokat. A szombati gyakorlat ezt szeretné megmutatni.
Mit nem érintet?
A közlemény szerint a gyakorlat nem befolyásolja a szolgáltatások elérhetőségét sem az AWS European Sovereign Cloud-on belül, sem az AWS többi Regiójára, és az AWS Direct Connecten keresztüli privát kapcsolatokra sem hat.
Rövid kapcsolati zavar viszont előfordulhat a teszt elején és végén. Ennek oka, hogy amikor a forgalom egyik internetes útvonalról a másikra vált, akkor a nem AWS-es hálózatoknak frissíteniük kell a routing információikat. Ez olyan, mint amikor a GPS-navigáció új útvonalat kalkulál: egy rövid ideig tart, utána minden a megszokott módon megy tovább.
A kezelő személyzet
Az üzemeltető csapat kizárólag EU-ban lakó és az EU-ban dolgozó szakemberekből áll. Emellett csak az AWS European Sovereign Cloud saját hardver- és szoftvererőforrásait használja. Ez a tesztet az AWS European Sovereign Cloud Managing Directorai rendelték el, hogy bemutassák a szolgáltatás működési függetlenségét.
Amit a szolgáltatásról érdemes tudni
Az AWS European Sovereign Cloud a németországi Brandenburgban található. Az adatközpontjai fizikailag és logikailag is elkülönülnek az AWS többi Régiójától, és a forráskódnak van egy helyi, EU-n belüli másolata. Az AWS közlése szerint az ügyféltartalom és az ügyfelek által létrehozott metaadat az EU-ban marad, a szolgáltatásnak nincsenek kritikus függőségei EU-n kívüli infrastruktúrától, és kizárólag EU-s lakosok üzemeltetik.
Felmerülhet a kérdés, hogy akkor miért csatlakozik a backbone-hoz. Az AWS indoklása szerint a backbone jobb teljesítményt, kapacitást, megbízhatóságot, biztonságot és költségmegtakarítást nyújt. Része az always-on titkosítás és a DDoS-védelem, és a backbone a közlemény szerint nem tudja visszafejteni az ügyfelek titkosított forgalmát. Az EU-t csak olyan adat hagyhatja el, amely nem ügyféltartalom és nem ügyfél által létrehozott metaadat, például az operatív adat.
Szabályozói háttér
Az AWS szerint a gyakorlatot az Európai Bizottság EU Cloud Sovereignty Framework (CSF) célkitűzéseivel és a német BSI C3A kritériumrendszerével összhangban tervezték. Mindkettő arról szól, hogy egy felhőszolgáltatás nyújtható-e függetlenül és önállóan.
Az egész eredménye további bizonyíték lesz az ügyfelek megfelelőségi csomagjaihoz. Ehhez az AWS kiadta az AWS European Sovereign Cloud: Sovereign Reference Framework (ESC-SRF) nevű dokumentumot is, amely kifejezetten hasznos infirmációkat és biztosíték leírásokat tartalmaz a szabályozóknak és a partnereknek.
Érdekesség
Ez az AWS saját maga által szervezett és bemutatott gyakorlat. Az AWS azt ígéri, hogy utána összefoglalót ad a szabályozóknak és az ügyfeleknek. Hogy ez az összefoglaló nyilvános lesz-e, azt a közlemény nem mondja ki. Ezt nem tudom biztosan. Azt sem tudom, pontosan meddig tart a gyakorlat, mert a bejelentés csak azt írja, hogy több órán át.
Ha olyan környezetben dolgozol, ahol az adatok helye és az üzemeltetők köre rendszeresen előkerülő kérdés, a szombat utáni beszámoló érdemes olvasmány lesz.
Legutóbb a KubernetesService-ekről volt szó: megnéztük, hogyan tesz elérhetővé egy alkalmazást a ClusterIP, a NodePort és a LoadBalancer típus. Ha olvastad, biztosan emlékszel, a cikknek a végén jeleztem, hogy az Ingress külön témát érdemel. Most ez következik, és mellé vesszük az utódját, a Gateway API-t is, mert 2026-ban már nem érdemes a kettőt egymástól függetlenül tanulni.
Mi a gond a sok LoadBalancer Service-el?
A LoadBalancer típusú Service egyszerű és gyorsan működik: a cloud provider létrehoz mögé egy valódi terheléselosztót Egyetlen alkalmazásnál ez teljesen rendben van. Tíz alkalmazásnál ez akár tíz külön terheléselosztót is jelenthet, amelyek külön cloud-erőforrásként költséget és üzemeltetési feladatot jelentenek. Ráadásul minden alkalmazás külön külső belépési pontot kaphat.
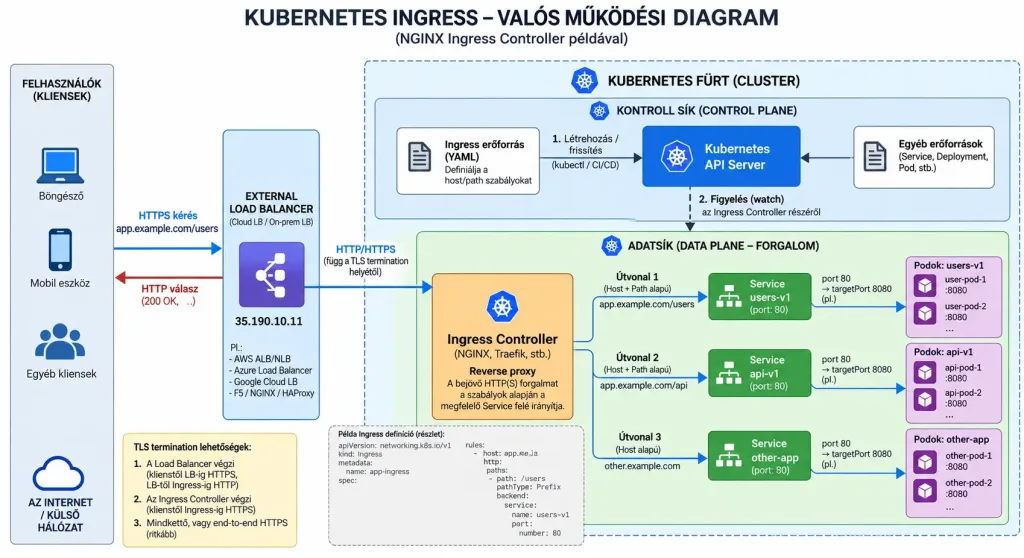
Az Ingress ezt a helyzetet oldja meg. Ahelyett, hogy minden Service saját belépési pontot kapna, egyetlen közös bejáratot hozunk létre, amely a kérés hostneve vagy útvonala (path) alapján dönti el, melyik Service felé menjen tovább a forgalom. A Service-ek közben maradhatnak egyszerű ClusterIP típusúak.
Egy egyszerű példa: a shop.pelda.hu kérései a webshop Service-hez mennek, az api.pelda.hu kérései az API-hoz, a shop.pelda.hu/admin pedig egy harmadik szolgáltatáshoz. Mindez egyetlen belépési ponton keresztül.
Ingress resource és Ingress controller
Az Ingress két részből áll, és ez a leggyakoribb félreértés forrása.
Az Ingress resource maga a szabálygyűjtemény. Egy YAML-ben leírt API objektum a networking.k8s.io/v1 csoportban, amelyet ugyanúgy kezelünk kubectl-lel, mint egy Deployment-et vagy egy Service-t.
Az Ingress controller az a komponens, amely ezeket a szabályokat végre is hajtja. Egy vezérlő komponens, amely a Kubernetes API-n keresztül figyeli az Ingress erőforrásokat, és azok alapján konfigurálja a forgalom kezelését. A controller megvalósítása környezettől függően futhat a clusterben vagy lehet a cloud provider által felügyelt komponens. A legtöbb controllerrel ellentétben nem része a kube-controller-manager-nek, ezért külön kell telepíteni. Controller nélkül az Ingress objektum létrejön, de semmi nem történik.
A Kubernetes dokumentációjában szereplő minimális példa így néz ki:
Az ingressClassName határozza meg, melyik controller foglalkozzon a szabállyal, mivel egy clusterben több controller is futhat egyszerre. Az annotations rész pedig már átvezet az Ingress korlátaihoz.
Ingress a három nagy felhőben
Managed Kubernetes esetén a controllert gyakran maga a felhőszolgáltató adja:
Ezek is valódi, fizetős cloud erőforrások. A különbség az, hogy egy közös belépési pont szolgál ki sok Service-t, így sokkal kevesebb terheléselosztót kell létrehozni és nyomon követni.
Azure-on az Application Gateway mellett az újabb Application Gateway for Containers megoldás is támogatja a Kubernetes Ingress és Gateway API erőforrásait. Google Cloud esetén a GKE-n a klasszikus Ingress megoldás továbbra is használható, de a Google a Gateway API használatát is támogatja és fejleszti az újabb forgalomkezelési funkciókhoz.
Hol ér véget az Ingress?
Az Ingress API szándékosan egyszerű: elsősorban HTTP(S) forgalom host- és path-alapú routingjára, valamint TLS kezelésére szolgál. Olyan fejlettebb funkciók, mint például a header alapú routing, a canary jellegű forgalommegosztás vagy a nem HTTP-alapú protokollok támogatása nem egységes részei az Ingress API-nak. Ezeket az egyes controllerek saját extensionökkel, például annotationökkel, ConfigMapekkel vagy CRD-kkel egészíthetik ki. Ez viszont controllerfüggőséget okozhat, és megnehezítheti a későbbi váltást.
Van egy szervezeti korlát is: az Ingress modellje kevésbé támogatja a platform- és alkalmazáscsapat felelősségeinek tiszta szétválasztását. A Gateway API-t ezzel szemben eleve szerepkörök szerinti felosztásra tervezték: a GatewayClass és Gateway tipikusan az infrastruktúra- vagy platformcsapat, míg a Route erőforrások az alkalmazáscsapatok kezelésében lehetnek.
Emiatt az Ingress API funkcionálisan be van fagyasztva: továbbra is támogatott, de új képességek már nem kerülnek bele. A fejlesztés a Gateway API-ban folytatódik.
Mi történt az ingress-nginx-szel?
Az ingress-nginx évekig az egyik legelterjedtebb Ingress controller volt, a legtöbb oktatóanyag ma is ezt mutatja be. A Kubernetes SIG Network és a Security Response Committee 2025 novemberében bejelentette a projekt nyugdíjazását. A karbantartás 2026 márciusáig tartott, azóta nem jelenik meg hozzá új kiadás, hibajavítás és biztonsági javítás sem. A meglévő telepítések tovább működnek, de a Kubernetes kifejezetten azt javasolja, hogy az érintettek tervezzék meg az átállást a Gateway API-ra vagy egy másik Ingress controllerre.
Fontos különbség, hogy ez a közösségi ingress-nginx projektre vonatkozik, nem az F5 által fejlesztett NGINX Ingress Controllerre. Hogy egy clusterben fut-e, azt a hivatalos ajánlás szerint így lehet ellenőrizni:
kubectl get pods --all-namespaces --selector app.kubernetes.io/name=ingress-nginx
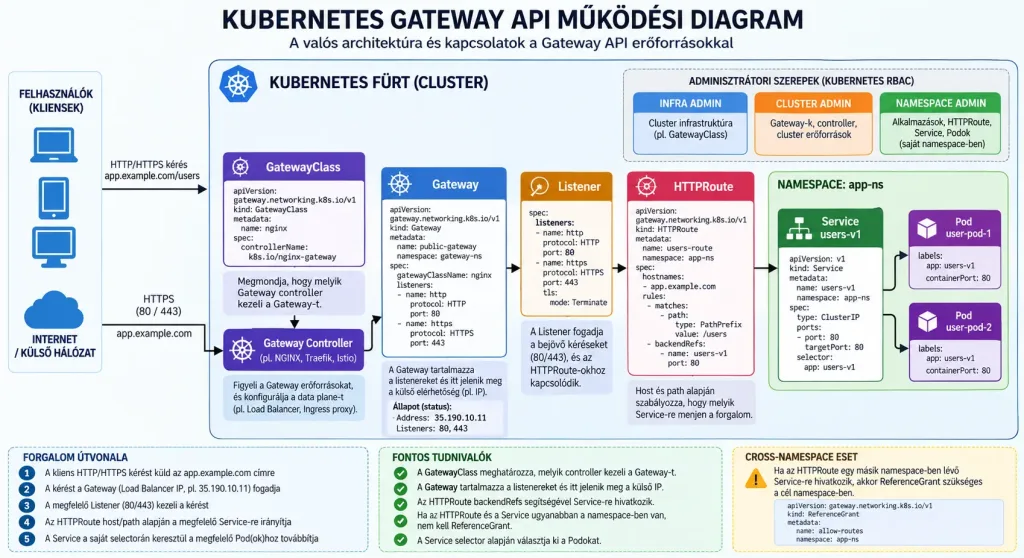
A Gateway API három szerepe
A Gateway API a gateway.networking.k8s.io/v1 csoportba tartozik, és a feladatot három stabil objektumra bontja:
Objektum
Mit ír le
Ki kezeli jellemzően
GatewayClass
Melyik controller valósítja meg a gateway-eket
Infrastruktúra csapat
Gateway
A belépési pont példánya: protokollok és portok
Platformcsapat
HTTPRoute
A routing szabályok a Service-ek felé
Fejlesztők
A hivatalos dokumentáció példája jól mutatja ezt a szétválasztást. A Gateway egy HTTP listenert nyit a 80-as porton:
Ami az Ingressben sokszor controller-specifikus extension vagy annotation volt, annak számos megfelelője a Gateway API szabványos része. Ilyen például a header- és path-alapú routing, illetve a súlyozott forgalommegosztás. További funkciók, például a request mirroring, szintén definiálva vannak a Gateway API-ban, de egyes funkciók Extended támogatási szinten vannak. A szabványos core funkciók használatával a konfiguráció hordozhatóbbá válik a különböző Gateway API implementációk között. Az implementation-specific vagy egyes Extended funkciók használata azonban továbbra is okozhat eltéréseket. A namespace-ek közötti hivatkozásokat pedig külön engedélyezni kell, ami biztonságosabbá teszi a több csapat által közösen használt clustereket.
A nagy felhőszolgáltatók is kínálnak Gateway API-alapú megoldásokat. GKE-n elérhető a Google által biztosított Gateway controller, Azure-on az Application Gateway for Containers támogatja a Gateway API-t, AWS-en pedig több megoldás is rendelkezésre áll, például az AWS Gateway API Controller VPC Lattice-t használva vagy az AWS Load Balancer Controller ALB-vel.
Amit nem részleteztem az Ingress esetén sem
Most nem tértünk ki a TLS tanúsítványok kezelésére, a controllerek telepítésének részleteire és az Ingressről Gateway API-ra történő migrációra. A service mesh is kimaradt, pedig például a rate limiting vagy a részletes forgalmi metrikák ott kapnak igazán szerepet. Ezek mind önálló cikket érdemelnek, és talán később sorra is kerülnek. A monitoring és a high availability szintén később lesz fontos, amikor az alapműködés már stabil.
Amire érdemes figyelni
Még az AI korában is könnyű egy régi dokumentációt követve ingress-nginx-szel indítani egy új projektet. Ezért azt javaslom, hogy mielőtt bármit telepítesz, nézd meg, hogy az adott eszköz aktívan karbantartott-e. Új környezetben érdemes egyből a Gateway API-val kezdeni, meglévő Ingress alapú rendszereknél pedig tervezetten, lépésenként átállni.
A költségoldalt se feledd: felhőben az Ingress vagy Gateway mögött gyakran valamilyen felügyelt terheléselosztó infrastruktúra áll, de ez az adott controller és cloud platform megvalósításától függ. Érdemes ezért azt is megnézni, milyen cloud-erőforrásokat hoz létre az adott implementáció, és ezek milyen költséggel járnak. Tesztelés után ugyanúgy érdemes törölni őket, mint az éjszakára bekapcsolva hagyott fejlesztői VM-eket.
Aki a Service-ek után az Ingres-t, majd a Gateway API-t is megérti, az már tisztán látja, hogyan jut el egy kérés a felhasználótól a Pod-ig. Ez az a pont, ahol a Kubernetes hálózatkezelése összeáll egy egésszé.
Lassan egy éve, hogy a Bitnami által fejlesztett Docker és Helm alapú megoldások fizetőssé váltak. Miután a Broadcom részévé vált, tudni lehetett, hogy a pénz legyőzi a lelkesedést. Ez akkor nem csupán néhány alkalmazást érintett, hanem minden olyan népszerű megoldást, amit sok-sok cég nap mint nap használ. (Redis, MariaDB, WordPress, RabbitMQ, stb)
Ugyan a bejelentés, hogy ez megtörténik, sokkal hamarabb ismert volt, mégis sokakat váratlanul ért 2025. szeptember 30-án. Aki addig nem készült fel, az hirtelen azzal szembesült, hogy alkalmazásai a Kubernetes cluster-en nem indulnak el többet, mert nem tudják letölteni, az addig ingyenesen hozzáférhető képfájlokat.
A nagyobb cégeknél és bizonyos felhőszolgáltatóknál még elérhetőek maradtak olyan szolgáltatások, amelyeknek ezen Bitnami-s megoldások voltak az alapjai. Ilyen volt például a WordPress az Amazon Lightsail-en belül
Néhány kattintás, 1-2 perc és volt egy működőképes WordPress oldalunk – Olcsón és gyorsan a felhőben. És a megszokott Bitnami minőségben.
Mi történt a WordPress-el?
Az Amazon Lightsail-ben a mai napig igénybe lehet venni a WordPress szolgáltatást. Továbbra is gyors, olcsó, kényelmes és kiváló megoldás kisebb és nagyobb cégeknek, ha meg akarják tapasztalni a valódi Cloud élményt.
A Lightsail szolgáltatást egyébként is szívesen ajánlom bárkinek, aki most ismerkedik a felhővel vagy kisebb cégeknek, akik professzionális szinten szeretnék cégeik alkalmazásait a felhőben futtatni. Ez egy külön világ az AWS-en belül.
Egy valódi svájci bicska, mert itt mindent megtalálható amire szüksége van egy ilyen cégnek: WordPress, domain, webtárhely, DNS, adatbázis, Docker, OpenClaw, biztonsági mentés, monitorozás.
Ami változott, hogy a WordPress-t már nem Bitnami alapokkal ajánlja az AWS. Helyette a saját megoldásukat tette elérhetővé, ami ugyanolyan stabil és gyors mint korábban.
WordPress by Lightsail
Ez az új neve, ezzel is jelezve, hogy az Amazon továbbra is komolyan gondolja azon célközönség támogatását és kiszolgálását, akik számára a Lightsail a tökéletes belépési pont a felhő világába.
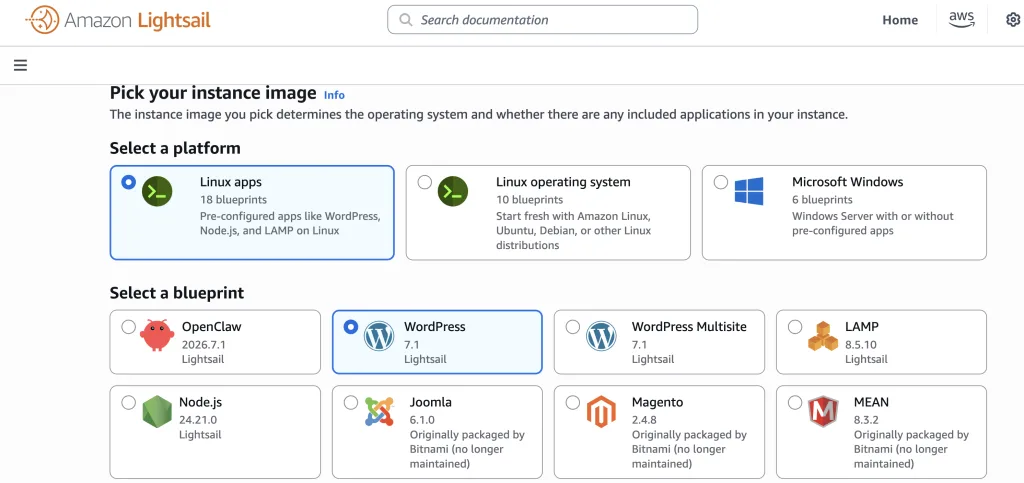
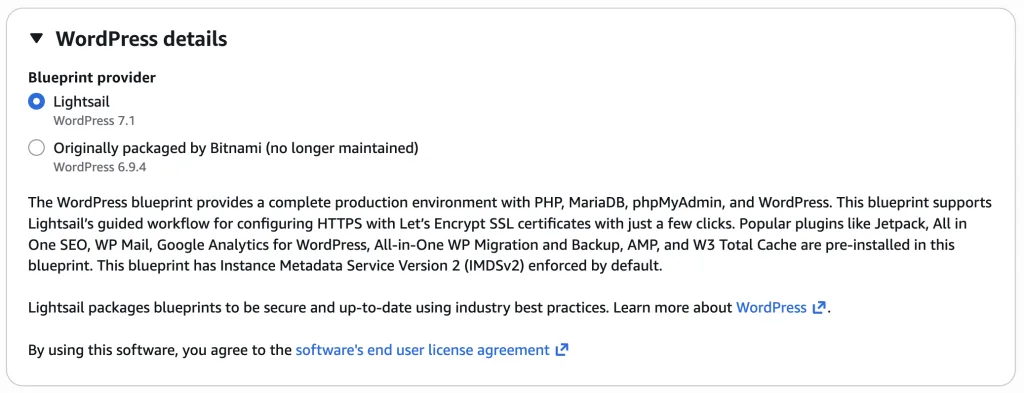
Amikor szeretnénk létrehozni egy új WordPress oldalt, akkor azonnal látjuk is miről van szó.
Egyértelműen közlik, hogy a Lightsail verziót érdemes választani, mert a Bitnami alapú megoldást már nem fejlesztik tovább (habár még elérhető). Valószínűleg hamarosan ki is lesz vezetve.
Áttérés az új megoldásra
Ha Te is használod a korábbi megoldást, akkor sem kell aggódnod, hogy mit hoz a jövő. Ugyanis az Amazon erre is gondolt. Egy nagyon jó leírást készített arról, hogyan lehet átköltöztetni a WordPress oldalaid teljes tartalmát (a fix IP-címmel együtt) a Lightsail változatra.
Ez a leírás valójában egy AWS specifikus leírása egy WordPress oldal migrációjának a beépített importáló eszközzel. Természetesen mindig vannak különleges, weboldal specifikus költözési lépések is, de a dokumentáció elég világosan fogalmaz ahhoz, hogy tudjuk, nálunk milyen további lépések szükségesek.
Ha pedig AWS-en kívülről szeretnél beköltözni, arra egy másik leírást javaslok.
WordPress AWS-en továbbra is
Habár a Bitnamitól hamarosan elbúcsúzunk itt is, az AWS továbbra is gondoskodik arról, hogy weboldalaink és így a cégünk által biztosított szolgáltatások tovább működjenek.
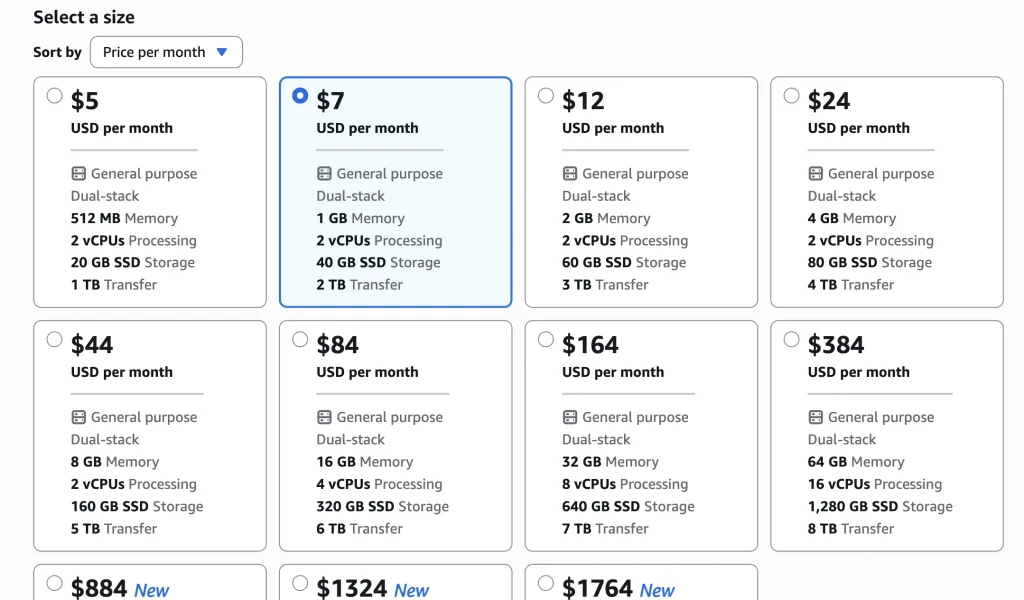
Kicsit átalakult az árazás is, mert korábban lehetőségünk volt kisebb weboldalakat 3 hónapig ingyenesen üzemeltetni. Ezek most megszűntek, de továbbra is alacsony áron juthatunk professzionális megoldásokhoz.
Aki még nem próbálta, annak javaslom, hogy hozzon létre egy ilyet és nézze meg milyen jól működik. És ha már a Ligthsail-ben jár, nézze meg a többi szolgáltatást is…megéri!
Van egy jól ismert kompromisszum, amivel container image alapú Lambda függvényeknél rendszeresen találkozhatunk. Ha valaki a Lambda kódját Docker image formában csomagolja – mert így illeszkedik a meglévő deployment gyakorlatához, vagy mert a függőségek mérete ezt indokolttá teszi -, akkor valamivel lassabb indulásra számíthat. Nem drámai várakozásról van szó, nem percekig tartó töltésről, hanem néhány másodperces különbségről, de ez bizonyos esetekben számít. Például egy interaktív API-nál vagy AI modellek kiszolgálásánál van jelentősége, mert ott a felhasználó valóban érzi a különbséget.
Ez a kompromisszum most kisebb lett hála a SnapStart funkciónak.
Mi változott pontosan
AWS 2026 szeptemberében elején jelentette be, hogy a Lambda SnapStart funkció mostantól container image formában csomagolt függvényekhez is elérhető. Korábban a SnapStart kizárólag a natív, zip alapú futtatókörnyezeteknél működött Python, .NET és Java esetén. A container image használat – amit sokan pont a nagyobb rugalmasság vagy a nagyobb méretkorlát miatt választanak – eddig kimaradt ebből.
Hogyan működik a SnapStart
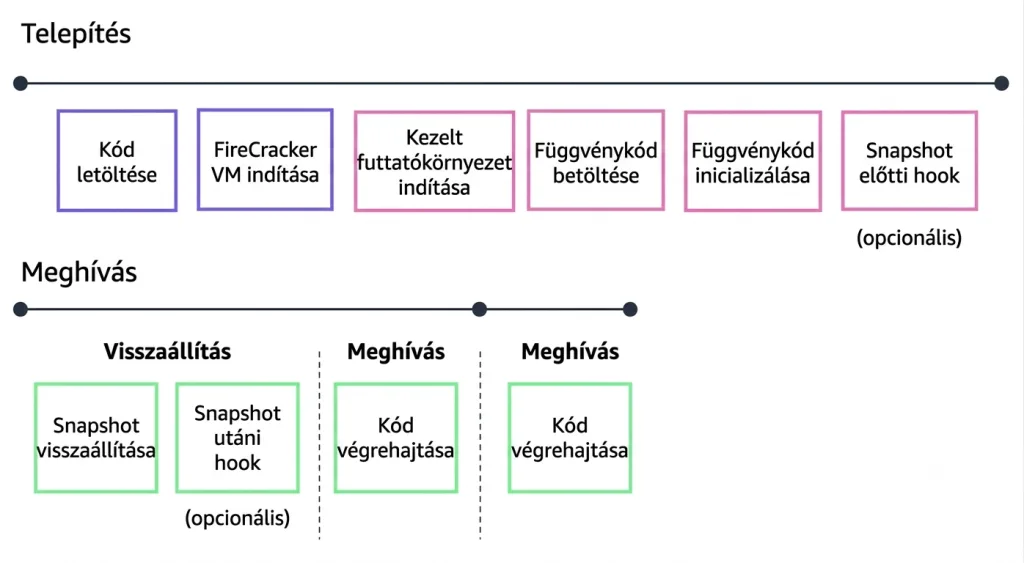
A SnapStart működése röviden így foglalható össze: A deployment (telepítés) időpontjában AWS elkészít egy pillanatképet a már előkészített futási környezetről, és ezt gyorsítótárba helyezi. Amikor egy hívás érkezik, Lambda nem nulláról indítja újra a runtime-ot és az alkalmazáskódot, hanem ebből a mentett állapotból folytatja. A gyakorlatban ez azt jelenti, hogy a néhány másodperces hidegindítási idő szinte nullára csökkenhet.
Hol érezhető a valódi különbség
A leginkább érintett terület a késleltetésre érzékeny felhasználási esetek köre: gépi tanulási modellek kiszolgálása, vagy olyan interaktív API-ok, amelyeknél a felhasználó valós időben vár válaszra. Ha egy szervezet eddig kifejezetten emiatt kerülte a container image használatát, és inkább zip formátumot használt (jóval merevebben, de gyorsabb indulással), mostantól már nem kell választania a kettő között.
Amire érdemes figyelni SnapStart esetén
A funkció aktiválása opcionális, és AWS Console, CLI, CloudFormation, SAM, SDK vagy CDK segítségével is bekapcsolható. Van azonban két dolog, amit érdemes előre tisztázni.
Nem minden AWS régióban érhető el egységesen, ezt régiónként ellenőrizni kell mielőtt használatba szeretnénk venni.
A felhasználói élmény attól is függ, milyen alap képet (base image) használunk: Java, Python és .NET esetén az újabb verziókkal ugyanúgy működik, mint a zip alapú függvényekével, míg más base image-eknél vagy egyedi image-eknél külön beállítások alkalmazás lehet szükséges (Pl.: runtime hook).
A SnapStart-nak emellett saját, külön árazási koncepciója van, amit érdemes megnézni, mielőtt bekapcsoljuk éles környezetben.
Nem mindenhol hatékony
A „kapcsoljuk be mindenhol, biztos jó lesz” hozzáállás elsőre jól hangzik. Azonban egy ilyen funkciónál pont az a lényeg, hogy célzottan alkalmazzuk. Ahol van értelme, azaz a „hidegindítás” ténylegesen felhasználói élményt vagy SLA-t befolyásol, nem pedig minden egyes függvénynél alapból. Aki csak azért kapcsolja be, mert elérhető, az extra komplexitást és valószínűleg extra költséget is behoz az eddigi működésbe.
A container image alapú Lambda funkciók eddig is jó választás voltak ott, ahol a csapat méret vagy standardizálás miatt ragaszkodott hozzá. Most ehhez a rugalmassághoz egy komoly indulási sebességbeli hátrány is megszűnt, ami a serverless architektúrák érettségét mutatja. Ez nem forradalmi újdonság, inkább egy hiányzó láncszem pótlása – de pont az ilyen apróságok a legszükségesebbek, amikor robosztus és kifinomult rendszert tervezünk.
Korábban már írtam olyan kiemelten fontos Kubernetes témáról, mint: hogyan kapcsolódnak a Pod-ok a Volume-okhoz, mire jó a PersistentVolume és a PersistentVolumeClaim, és hogyan automatizálja ezt a StorageClass a Dynamic Provisioning-on keresztül. Legutóbb pedig a Secret és a ConfigMap rejtelmeibe avattalak be Titeket. Most nézzünk egy másik alapvető fogalmat, ami nélkül a Kubernetes cluster gyakorlatilag használhatatlan lenne: a Service-eket.
Miért van szükség a Service-re?
A Kubernetes architektúrája arra épül, hogy a Pod-ok ideiglenesek. Bármelyik Pod bármikor megszűnhet, és egy újjal helyettesítődik – más IP-vel. Ha egy alkalmazás közvetlenül egy Pod IP-jére hivatkozna, minden újraindításnál elromlana a kapcsolat. A
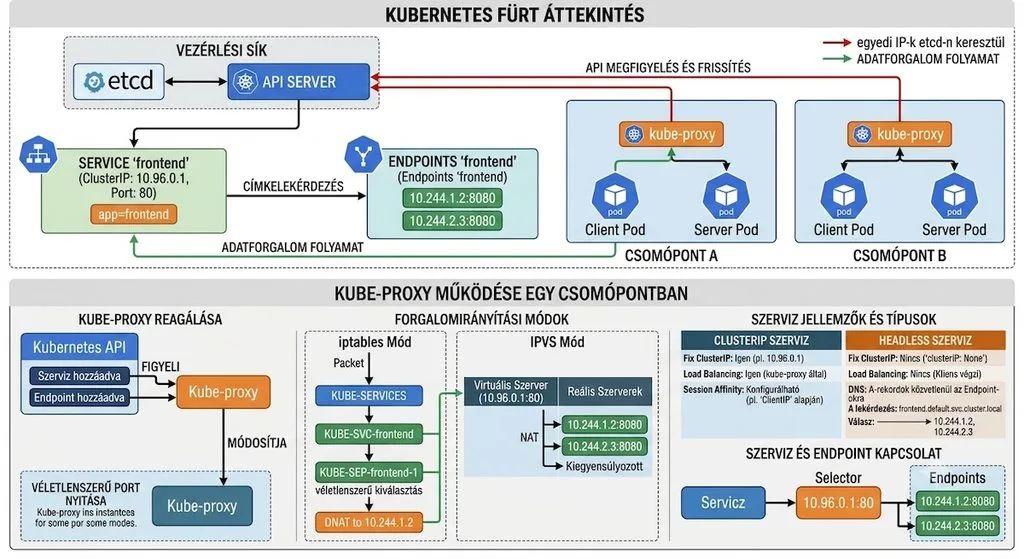
pontosan ezt a problémát oldja meg: label-ek (címkék) alapján összeköti a Pod-okat egymással, vagy elérhetővé teszi őket a cluster-en kívülről is. Amikor egy Pod lecserélésre kerül, a Service – egy Endpoint objektumon keresztül – automatikusan az új Pod-hoz irányítja a forgalmat.
Hogyan irányítja a forgalmat a kube-proxy
A háttérben a kube-proxy figyeli a Kubernetes API-t, és minden node-on reagál az új Service-ekre és Endpoint-okra. Véletlenszerű portokat nyit, figyeli a forgalmat a ClusterIP:Port címen, és onnan irányítja tovább a generált endpoint-okhoz. A Service automatikus load balancingot biztosít a label query alapján, session affinity IP alapján konfigurálható, és létezik úgynevezett headless service is, amelynek nincs fix IP-je és load balancingja. Az egyedi IP-ket a Service-ek az etcd adatbázison keresztül kapják, a forgalomirányítást pedig jellemzően iptables vagy ipvs végzi.
A négy alapvető típus
Típus
Mire jó
ClusterIP
Alapértelmezett típus, csak belső elérést biztosít a cluster-en belül
NodePort
Debugoláshoz vagy statikus IP-hez hasznos, például tűzfalon átengedett porthoz
LoadBalancer
A cloud provider (pl. GKE, AWS) felé küld kérést egy load balancer létrehozására
ExternalName
Nincs selectora, se portja – DNS szinten ad vissza egy aliast egy külső erőforráshoz
Fontos tisztázni egy gyakori félreértést: a LoadBalancer típus önmagában nem hoz létre load balancert. Először egy NodePort-ot készít, majd aszinkron kérést küld a load balancer létrehozására. Ha van olyan komponens, ami reagál erre a kérésre – ahogy ez publikus cloud környezetben történik –, akkor létrejön a load balancer. Ha nincs ilyen figyelő komponens, a Service állapota Pending marad.
Hogyan frissül egy Service működés közben
A label-ek (címkék) határozzák meg, mely Pod-ok kapják meg a forgalmat egy Service-től. Az alapértelmezett frissítési minta a rolling deployment: az új verziójú Pod-ok bekerülnek, és az automatikus load balancing miatt a régi verzióval együtt kapnak forgalmat. Ha a különböző verziók nem kompatibilisek egymással, érdemes verziószámot is tartalmazó, specifikusabb label-t használni a deploymenthez. Amikor a deployment létrehozza az új replicaSet-et a frissítéshez, a label nem fog egyezni – így csak azután áll át rá a forgalom, hogy manuálisan módosítjuk, mihez kapcsolódjon a Service. Ez minimalizálja a verziók közötti összezavarodást a kliens oldalon.
Egy példán keresztül
A leggyorsabb módja annak, hogy egy meglévő deploymenthez Service-t rendeljünk, a kubectl expose parancs:
kubectl expose deployment/nginx --port=80 --type=NodePort
kubectl get svc
Ez létrehoz egy Service-t, amely a 80-as portot használja, és véletlenszerű portot generál minden node-on. A port és a targetPort explicit is megadható, ha nem szeretnénk véletlenszerű értékeket – a targetPort alapból megegyezik a porttal, de akár egy Pod-on belüli port nevére is hivatkozhat.
DNS és a Service-ek
A CoreDNS az alapértelmezett DNS megoldás v1.13 óta. Induláskor egy szervert futtat a konfigurált zónákhoz, és plugin láncokat tölt be a további funkciókhoz – a beépített, körülbelül harminc plugin fedi le a leggyakoribb igényeket, például metrikák szolgáltatását Prometheus felé, hibalogolást vagy TLS tanúsítványkezelést. A klienseknek a kube-dns service-en keresztül van elérésük ehhez. Ha a DNS regisztrációt szeretnénk ellenőrizni, a legegyszerűbb módszer egy shell-t és hálózati eszközöket (nslookup, dig, nc) tartalmazó Pod indítása, majd a Service-en keresztüli lekérdezés – a /etc/resolv.conf fájl, a label-ek, a selector-ok és a Network Policy-k is befolyásolhatják az eredményt.
Amit szándékosan kihagytunk
Ebben a cikkben nem tértünk ki az Ingress controllerre, ami külön, a szolgáltatásokra épülő komponens, és a forgalmat URL alapján irányítja a megfelelő Service felé – ez önálló témát érdemel. Szintén nem foglalkoztunk a monitoringgal vagy a high availability beállításokkal, mert ezek külön réteget jelentenek a Service-ek alapműködése fölött.
Amire érdemes figyelni
Azure, AWS, Google Cloud és általában a felhőszolgáltatóknál a LoadBalancer típusú Service-eknél sokan elfelejtik, hogy ez valódi, fizetős cloud erőforrást hoz létre a háttérben. Teszteléskor könnyű több ilyen Service-t is létrehozni, majd elfeledkezni róluk – ez ugyanolyan felesleges költséget generál, mint egy éjszakára bekapcsolva hagyott fejlesztői VM. Érdemes rendszeresen átnézni, mely Service-ek futnak LoadBalancer típussal, és amelyikre nincs szükség, azt törölni.
A tanulás fontos, és sokszor nehéz jó anyagot találni hozzá. A felhő esetén ez hatványozottan igaz, hiszen sok anyag van, de a minőségük vegyes. Az igazán jók pedig még fizetősek is. Ennek mondott ellent az AWS Cloud Quest, ahol például egy digitális világon és különböző küldetéseken keresztül barangolhatunk be egy várost, miközben megismerkedünk az AWS alap szolgáltatásaival. Ez igazán innovatív megoldás volt, ezért ajánlottam már több mentoráltamnak is.
Most pedig itt a hír: augusztus 11-én érkezik a teljesen megújult 2.0-s verzió, és az AWS Community Builder közösségben is érezhető a felfokozott hangulat körülötte.
Mi változik pontosan
A legnagyobb újdonság az úgynevezett AI Dialogue: a feladatok elején egy virtuális ügyféllel folytatsz AI-alapú beszélgetést, ahol jó kérdéseket kell feltenned, mielőtt megoldást tervezel. Ez pontosan az a gondolkodásmód, amit enterprise környezetben is elvárnak egy architect-től. Fontos, hogy ez az egyetlen pont a játékban, ahol AI-t használnak, a labor-feladatok, videók és kvízek továbbra is szakértők által összeállítottak.
Amit érdemes tudni
Kilenc szerepkör épül be, mindegyikhez saját AWS badge jár. A Cloud Practitioner és a Generative AI Practitioner ingyenes, a többi hét a Skill Builder előfizetéshez kötött. Újdonság, hogy a labor-feladatok újrajátszása mostantól az ingyenes szinten is elérhető. A meglévő játékosok badge-ei, előrehaladása és teljesített feladatai automatikusan átkerülnek, és egy welcome-back ajándék is vár rájuk.
„Save the date”
Augusztus 11. 15:00 – ekkor válik élessé az új Cloud Quest az AWS Skill Builder-en. Ha eddig csak hallottál róla, ez jó alkalom, hogy nekifuss.
Én már nagyon kíváncsi vagyok milyen lesz testközelből. Nézd meg Te is!
Néhány hete készítettem egy rövid videót azoknak, akik most ismerkednek a Google Cloud-ökoszisztémával vagy a Geminivel, mert azt tapasztalom, hogy sokan itt akadnak el már az első lépésnél. Pedig ennél egyszerűbb dolog nem is lehetne.
Az első lépések nem egyszerűek, de itt más a helyzet: az ember azt hiszi, hogy a Google AI-hoz és a Google Cloudhoz külön-külön fiókokat kell létrehoznia. Ez nem igaz. Egy meglévő Gmail-fiók pontosan elég ahhoz, hogy az egész ökoszisztémát bejárd.
Négy URL, egy fiók
A videóban négy belépési pontot mutatok meg, mindegyiket ugyanazzal az e-mail-címmel:
Ez a négy hely gyakorlatilag lefedi a Google AI és Cloud ökoszisztémájának egészét. Nincs itt semmi extra regisztráció, nincs elveszett jelszó egy külön fejlesztői fiókhoz, nincs felesleges adminisztráció.
Miért fontos ez?
Aki most vág bele a felhő vagy az AI világába, annak az első akadály gyakran nem technikai, hanem szervezési: hova is kattintsak, melyik fiókkal, melyik felületen. Ha ez az első lépés egyszerű, sokkal nagyobb eséllyel megy tovább valaki a következőre is. Ez pontosan az a simplicity-elv, amit enterprise környezetben is vallok: előbb működjön egyszerűen, utána lehet bővíteni.
Mielőtt megnézed
Ha eddig azt hitted, hogy a Google Cloud vagy a Gemini kipróbálásához külön fiókra vagy bonyolult regisztrációra van szükséged, a videó pontosan azt mutatja meg, hogy ez nem így van. Egy fiók, négy URL, és már úton is vagy a felhő és az AI világába.
Egy ideje már nem írtam cikket a Kubernetes-ről, pedig mint tudjátok szeretem ezt a témát. Amikor a Kubernetes API-ról írtam, sokan kérdezték, hogy jó, de mi történik egy deployment esetén valójában, amikor kiadunk egy kubectl apply parancsot. Most erről szeretnék írni nektek: mi zajlik a színfalak mögött, amikor egy Deployment-et létrehozunk, frissítünk, vagy éppen visszaállítunk egy korábbi verzióra.
Mi történik, amikor létrehozunk egy Deployment-et
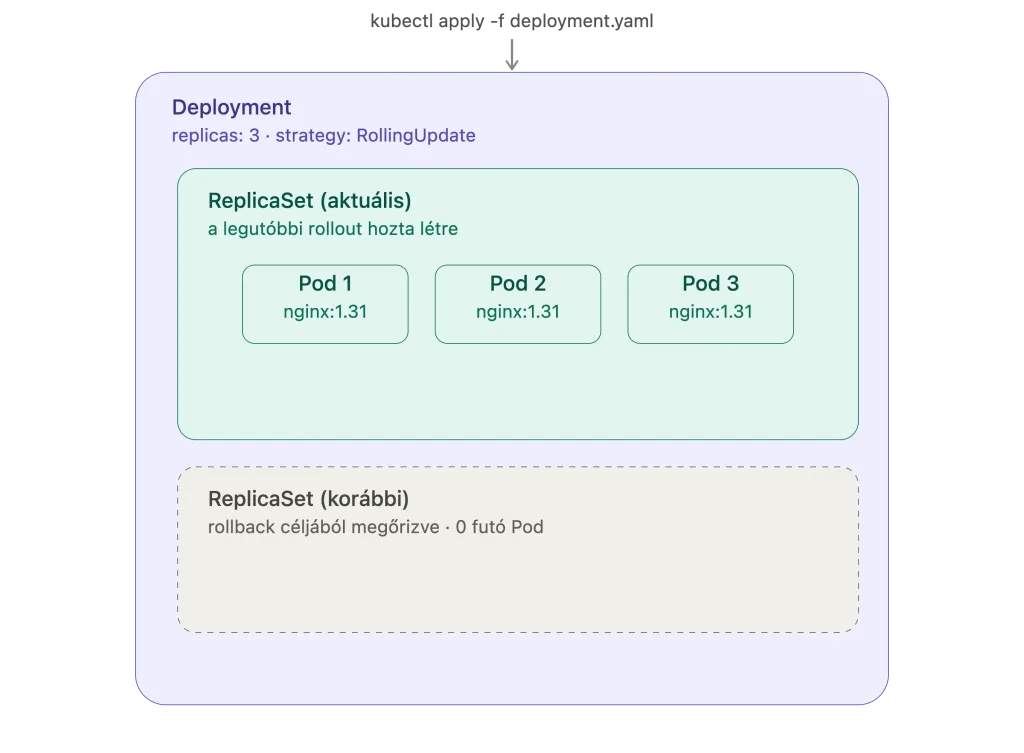
A Deployment egy YAML vagy JSON specifikációból épül fel. Amint bekerül a clusterbe, a controller automatikusan létrehoz egy ReplicaSet-et, az pedig legenerálja a Podokat. Ha egy egyszerű nginx web szervert szeretnénk futtatni, a parancs ennyi:
A rendszer válasza egyszerű visszaigazolás, hogy a deployment létrejött. Ha meg akarjuk nézni, mi került létre a háttérben, a kubectl get deployments,rs,pods -o yaml paranccsal kérhetjük le a teljes objektumfát. Én gyakran ezzel kezdek, amikor egy hibát próbálok visszakövetni, mert így látom, hogy a Deployment, a ReplicaSet és a Pod pontosan hogyan kapcsolódik egymáshoz.
Hogyan is néz ez akkor ki? Mik a fő összetevői?
A metadata blokk – mit érdemes tudni róla
Minden objektumnak van egy metadata szekciója, amiben nem a működést, hanem az azonosítást és a nyomon követést segítő adatok vannak. Itt találjuk a labeleket, az annotációkat, a létrehozás időpontját (creationTimestamp), valamint egy uid mezőt, amely az objektum egész életciklusa alatt egyedi marad. A generation mező azt mutatja, hányszor módosították az objektumot – ez praktikus, ha egy rollout történetét szeretnénk visszakövetni.
Fontos különbség, hogy az annotációk nem használhatók objektumok kiválasztására kubectl paranccsal, ellentétben a labelekkel. Ezt sokan összekeverik kezdőként, pedig a különbség lényegi: az annotáció információt hordoz, a label viszont szelekciós eszköz.
A spec – itt dől el, hogyan frissül a rendszer
A Deployment specifikációjában két külön spec blokk van: az egyik a ReplicaSet-et, a másik a Podot konfigurálja. A ReplicaSet szintű spec tartalmazza a replikák számát (replicas), a selector.matchLabels mezőt, amely meghatározza, mely Podokat tekinti a rendszer a sajátjának, valamint a frissítési stratégiát.
A strategy mező alapértelmezetten RollingUpdate, ami azt jelenti, hogy a frissítés fokozatosan történik: a maxSurge határozza meg, hány új Pod jöhet létre a régiek törlése előtt, a maxUnavailable pedig azt, hány Pod lehet átmenetileg nem elérhető. Ha ezt Recreate-re állítjuk, a rendszer előbb töröl minden meglévő Podot, és csak azután hozza létre az újakat – ez egyszerűbb, de rövid kiesést okoz.
A Pod template – a konténer tényleges beállításai
A Deployment egyik legfontosabb része a Pod template, mert ez határozza meg, milyen konténer fut valójában. Itt szerepel az image neve és verziója, az imagePullPolicy, amely azt szabályozza, mikor töltse le újra a rendszer az image-et, valamint a restartPolicy, amely biztosítja, hogy egy leállt konténer automatikusan újrainduljon.
Érdemes megjegyezni, hogy a resources mező alapértelmezetten üres. Ez azt jelenti, hogy ha nem állítunk be CPU vagy memória limitet, a konténer korlátlanul foglalhatja ezeket az erőforrásokat. Ez az egyik leggyakoribb kezdő hiba, amit én is sokszor láttam: valaki elindít egy tesztelési célú Podot limit nélkül, és napok múlva veszi észre, hogy az felzabálja a node erőforrásait.
A status – amit a rendszer visszamond
A status blokk nem konfiguráció, hanem visszajelzés. Az availableReplicas és a readyReplicas összevetésével látjuk, hogy a kívánt állapot valóban létrejött-e. A conditions mezőben szöveges üzenetek is megjelennek, például hogy a Deployment elérte a minimális elérhetőséget, vagy hogy egy új ReplicaSet sikeresen kigördült. Az observedGeneration pedig azt mutatja, hányszor követte a rendszer a konfiguráció változását – ez jó kiindulópont, ha egy rollout állapotát szeretnénk diagnosztizálni.
A replikák száma egy egyszerű paranccsal módosítható:
kubectl scale deploy/dev-web --replicas=4
Ha a replikák számát nullára állítjuk, a konténerek megszűnnek, de a Deployment és a ReplicaSet objektum megmarad – ez pontosan az, ami a háttérben történik, amikor egy Deployment-et törlünk.
Nem minden mező módosítható szabadon, egyes értékek immutable-ek, ez verziófüggő. Az image verziójának módosítása viszont mindig lehetséges, és kubectl edit deployment paranccsal élőben is elvégezhető. Egy ilyen módosítás automatikusan elindítja a rolling update-et.
Ha valami elromlik – rollback
Az egyik legmegnyugtatóbb tulajdonsága a Deployment-eknek, hogy a korábbi ReplicaSet verziók megmaradnak, így vissza lehet állítani egy működő állapotot. Ha egy image frissítés hibás verzióra mutat, és a Podok ImagePullBackOff állapotba kerülnek, a kubectl rollout undo deployment/ghost paranccsal egyszerűen visszaléphetünk. Konkrét revízióra is visszaállhatunk a --to-revision opcióval. A kubectl rollout pause és resume parancsok pedig lehetővé teszik, hogy egy rollout közepén megállítsuk, majd később folytassuk a folyamatot.
DaemonSet – amikor minden node-on kell egy Pod
A DaemonSet más logikát követ, mint a Deployment: biztosítja, hogy minden node-on pontosan egy Pod fusson ugyanazzal az image-dzsel. Ha új node kerül a clusterbe, a DaemonSet automatikusan odatelepíti a Podot, ha egy node kikerül, a Pod is törlődik vele. Ez tipikusan logolási vagy metrika-gyűjtő ügynökök esetén hasznos, ahol fontos, hogy minden node-on futnia kelljen az adott komponensnek, anélkül, hogy erről manuálisan kellene gondoskodni.
Labelek – a cluster rendezésének kulcsa
A labelek nem API objektumok, mégis a Kubernetes-alapú üzemeltetés egyik legfontosabb eszközei. Bármilyen objektumhoz rendelhetünk kulcs-érték párokat, és ezek alapján szűrhetünk, csoportosíthatunk. A kubectl get pods -l run=ghost parancs pontosan ezt teszi lehetővé. Fontos, hogy egy Deployment label selectora apps/v1 API verziótól kezdve immutable, tehát létrehozás után már nem módosítható.
A labelek gyakorlati haszna a nodeSelector alkalmazásánál a legszemléletesebb: ha egy node-hoz disktype: ssd labelt rendelünk, egy Pod specifikációjában megadhatjuk, hogy csak ilyen node-ra kerüljön ki. Ez egyszerű, de sokat elárul arról, hogy a Kubernetes tervezésekor mennyire tudatosan gondolták végig a rugalmas, ám átlátható erőforrás-kezelést.
És mi a lényeg?
A Deployment látszólag egyszerű objektum, de a mögötte húzódó réteges struktúra – metadata, spec, template, status – valójában egy jól megtervezett állapotgép. Aki most kezd Kubernetes-szel dolgozni, annak érdemes megszokni, hogy minden változás egy új ReplicaSet-et generál, és hogy a resources mező üresen hagyása előbb-utóbb kellemetlen meglepetést hoz. Ez az egyik legjellemzőbb kezdő csapda, amivel én is sokszor szembesültem: a rendszer működik, csak épp senki nem korlátozta, mennyi erőforrást használhat.
Ha valaki mélyebben szeretné megérteni ezt a réteges logikát, a managed Kubernetes szolgáltatások, mint az AzureAKS, az AWS EKS vagy a Google CloudGKE, jó kiindulópontot adnak, mert ugyanezt az alapstruktúrát használják, csak a klaszter üzemeltetését veszik le a fejlesztő kezéből.
Rendszeresen készítek videós képzéseket, és minden alkalommal ugyanazzal a kihívással szembesülök. A videók szépen ott vannak az S3-on, mappákba rendezve, de minden, ami ezen felül fontos lenne, egy külön jegyzetben van: melyik anyaghoz milyen felirat tartozik, milyen kapcsolódo linkek vannak, melyik leckéhez kell még kiegészítő információ. Ezt a jegyzetet frissítgetem, és ezt küldöm el a Mentor Klubnak minden alkalommal, amikor egy új anyag elkészül.
Az AWS most pont ebben könnyítette meg a mindennapjaim: az S3-ba egy új funkciót épített be, az annotációt, amivel ez a fajta extra kontextus nem a videó mellett, hanem magában az objektumban lehet.
Mi az annotáció?
Az S3-hoz mostantól objektumonként akár 1000 darab, egyenként 1 MB méretű, összesen 1 GB-os annotációt lehet csatolni. A formátum kötetlen: JSON, XML, YAML vagy sima szöveg is lehet. A lényeg, hogy ez nem statikus.
Bármikor módosíthatod vagy törölheted, anélkül hogy az objektumot újra kellene írni. Ha az objektum másolódik, replikálódik vagy régiók között mozog, az annotáció vele megy. Ha törlöd az objektumot, az annotáció is eltűnik vele.
Hogy viszonyul ez a korábbiakhoz?
Az S3-ban eddig is volt pár módja annak, hogy infót tegyél egy objektumra, csak mindegyiknek volt egy szűk korlátja. A system-defined metadata fix dolgokat ad, mint a méret vagy a storage class, ezt nem te írod. A user-defined metadata feltöltéskor írható, de csak 2 KB-ig, és utána már nem módosítható. Az object tag-ek jól jönnek hozzáférés-vezérléshez vagy lifecycle szabályokhoz, de korlátozott számban definiálhatók, és messze nem elég nagyok komolyabb kontextushoz.
Így néz ki ez egymás mellett:
Metaadat típus
Max méret
Módosítható?
Mire jó
System-defined metadata
Fix
Nem
Objektum tulajdonságok: méret, storage class, létrehozás ideje
Az annotáció pont azt a hiányt tölti be, amit a másik három együtt sem tud: nagy méret, rugalmas formátum, és bármikor módosítható tartalom.
Hogyan állítod be valójában?
Tegyük fel, hogy van egy videód az S3-ban, és hozzá akarod csatolni a technikai specifikációit, vagy felitaror, vagy egy linket. Készítesz egy mediainfo.json fájlt a gépeden, benne a kódolással, felbontással, hangsávok számával és minden szükséges információval. Aztán az AWS CLI-vel egyetlen paranccsal csatolod az objektumhoz:
Ha egy másik csapat ugyanerre a videóra egy AI-generált összefoglalót is rátenne, simán megteheti egy másik annotáció néven, mondjuk ai_summary alatt, anélkül hogy a mediainfo annotációhoz hozzáérne. A kettő egymástól függetlenül él, frissül, törlődik.
Ha meg akarod nézni, mi van összesen egy objektumon, a list-object-annotations parancs kilistázza az összeset, a delete-object-annotation pedig eltávolít egyet, ha már nincs rá szükség.
A lekérdezhetőség, ahol a legjobb
A valódi potenciál nem az egyedi objektumokban van, hanem abban, hogy az annotációkat egyszerre, sok ezer vagy millió objektumon át is le tudod kérdezni. Ha bekapcsolod az S3 Metadata funkciót, az annotációk automatikusan bekerülnek egy felügyelt Apache Iceberg táblába, amit Amazon Athenával lekérdezhetsz.
Egy egyszerű SQL lekérdezéssel megtalálod például az összes videót, amelynek nyolcnál több hangsávja van, anélkül hogy egyenként át kellene nézned a fájlokat. És itt jön be az agentic AI: az S3 Tables MCP szerveren keresztül egy AI agent természetes nyelven is rákérdezhet az adatokra, mondjuk hogy keresse meg az összes AWS képzésekhez tartozó videót ami AI témájú, és a válasz másodperceken belül megjön.
Ezt a fajta szétcsúszást bárki jól ismeri, még ha nem is S3 vagy videók tekintetében. Nehéz az ilyen jellegű információkat összehangolni. Persze az annotáció sem oldja ezt meg varázsütésre, de legalább segít helyre tenni a dolgokat, tehát: az információ nem egy külön fájlban, hanem magán a videón van.
Mire figyelj?
Két dologra biztosan figyelj.
Az első a jogosultság: az IAM policy-ban vagy bucket policy-ban explicit engedélyezni kell az s3:PutObjectAnnotation és s3:GetObjectAnnotation action-öket, ezek nélkül semmi nem fog működni.
A második, és ebbe szerintem sokan bele fognak futni: az annotáció tárolása mindig S3 Standard díjszabás szerint történik, függetlenül attól, hogy az alapobjektum melyik storage class-ban van. Ha archív, Glacier-ben pihenő objektumokra kezdesz el nagy, JSON-ös annotációkat pakolni csak mert lehet, simán meglepődhetsz a számlán a hónap végén. Pont az a fajta tervezés nélküli felhőhasználat ez, amitől általában óvni szoktam mindenkit.
Kinek hasznos, és kinek nem
Tudom, hogy a magyar piacon még kevés cég épít komoly multi-agent rendszereket, ezért jogos a kérdés, hogy ez most kinek szól. A válaszom: nem csak azoknak, akik már AI agenteket futtatnak élesben. Ha bármilyen S3-ban tárolt „adatvagyonod” van, médiafájlok, dokumentumok, log-ok, exportok, és eddig külön rendszerben tartottad nyilván, hogy mi van bennük, az annotáció egy egyszerűbb és olcsóbb módja annak, hogy ezt egy helyen kezeld.
Érdemes tudni, hogy az Azure Blob Storage-nak és a Google Cloud Storage-nak is van saját metadata és tag mechanizmusa, de ezek mérete és rugalmassága jellemzően jóval kisebb ennél. Az S3 annotáció abban hoz újat, hogy ilyen méretben, akár 1 GB-ig, ilyen formátum-szabadsággal, és ennyire szorosan az AI agent munkafolyamatokhoz illesztve teszi ezt elérhetővé.
Amit szándékosan nem fejtek ki most: hogyan tervezd meg az annotációk séma-struktúráját nagy skálán, hogyan optimalizáld az Athena lekérdezések költségét, vagy hogyan állítsd fel a governance modellt arra, ki írhat és törölhet annotációkat nagyvállalati környezetben. Ezek mind valós kérdések, amint egy csapat mérete megnövekszik, de ez már egy külön cikk témája lehetne.
Habár elsőre nem nagy dolog, én látom a pozitív hozadékát. Sokak életét fogja megkönnyíteni ez az apró funkció: nálam a videós képzéseknél, máshol talán egy egész csapatnál, ahol eddig külön rendszerben tartották nyilván, mi tartozik egy fájlhoz. Kis lépés, de ettől nem kisebb a haszna.
Amikor valaki felhő alapú projektet tervez, általában csak egy szolgáltatóban gondolkozik. Ez a természetes irány, és nem is meglepő – egy rendszer, egy számla, minden egy helyen. Ez az általános trend.
Pedig aki alaposan ismeri az AWS-t, az Azure-t és a Google Cloud-ot, hamar rájön: mindegyiknek vannak erősségei, és mindegyiknek vannak gyengeségei. Ha valaki engem kérdezne, hogy mi lenne egy nagy, vállalati szintű megoldás tökéletes kivitelezése, azt mondanám: mindegyikből a legjobbat használjuk. Azonban ez sajnos a legtöbb esetben nem lehetséges.
Miért ragad be mindenki egyetlen szolgáltatónál?
A válasz általában nem technikai – hanem emberi. Aki egyszer megismerte az AWS konzolt, az ott érzi magát otthon. A csapat ott szerzett tapasztalatot, azzal kapcsolatban vannak a tanúsítványok, és az architektúra is arra épül. Váltani vagy párhuzamosan üzemeltetni látszólag bonyolultabb, drágább, és több kockázattal jár.
Ehhez jön hozzá a vendor lock-in jelensége. Az iparági ajánlás egyértelmű: kerüld el, maradj hordozható, ne függj egyetlen szolgáltatótól. A valóságban azonban ez szinte lehetetlen.
Minél mélyebbre ásol egy platform saját szolgáltatásaiban – saját adatbázisok, saját AI eszközök, saját hálózati megoldások – annál inkább benne vagy. És ha egyszer erre építed az architektúrát, a váltás költsége a legtöbb esetben meghaladja a maradás kényelmetlenségét. A nagy szolgáltatók pontosan tudják ezt, és az árazásuk is ezt tükrözi. Aki már látott hosszú távú enterprise szerződést egy nagy felhőszolgáltatóval, az tudja, miről beszélek.
A multicloud lényege egyszerű: nem egy szolgáltatóban gondolkozol, hanem oda teszed a munkaterhelést, ahol az adott feladatra a legjobb eszközök vannak. Az analitika mehet Google Cloud-ra, a gépi tanulási infrastruktúra AWS-re, a Microsoft-integrációk Azure-ra.
A hybrid cloud pedig azt jelenti, hogy a saját adatközpontod és a felhő együtt dolgozik – nem vagy kénytelen mindent kiszervezni.
A valóságban persze ez sem ilyen egyszerű. Mert ha két felhő között adatot kell mozgatni, azonnal felmerül a kérdés: hogyan? A nyilvános interneten keresztül? Az lassabb, kiszámíthatatlanabb, és biztonsági szempontból sem ideális. Dedikált fizikai kapcsolattal? Az drága, lassan kivitelezhető, és komoly hálózati szaktudást igényel. Pontosan itt jön képbe az AWS Interconnect.
Mi az AWS Interconnect?
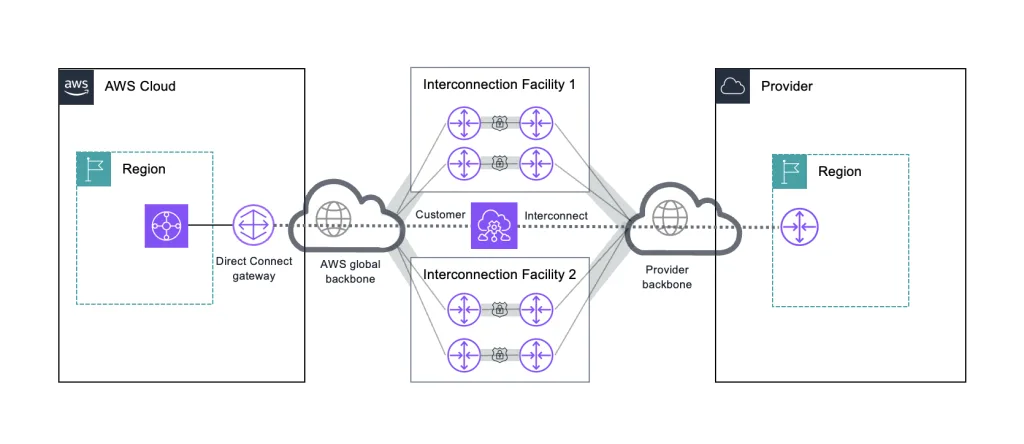
Az AWS Interconnect egy viszonylag friss szolgáltatás, amelyet pontosan erre a problémára terveztek. A hagyományos megközelítésben privát kapcsolatot létrehozni két felhő között fizikai routerek konfigurálását, BGP peering beállítást és cross-connect megrendeléseket jelentett – ez hónapokat és komoly szakértelmet igényelt. Az Interconnect ezt váltja ki.
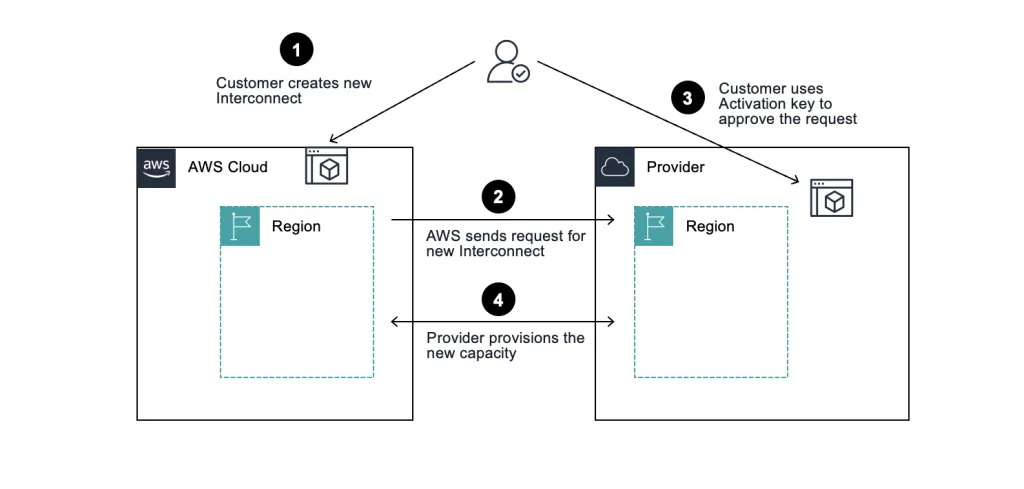
A folyamat leegyszerűsödik: kiválasztod a régiót, a szükséges sávszélességet és a szolgáltatót, az AWS és a partner pedig percek alatt előkészíti a kapcsolatot. A felhasználó mindebből egyetlen logikai objektumot lát a konzolban – a háttérben zajló redundáns infrastruktúra, a fizikai helyszínek és az MACsec titkosítás mind el van rejtve.
A szolgáltatásnak két arca van:
A multicloud változat, amely AWS VPC-ket köt össze más felhőszolgáltatók hálózataival – jelenleg Google Cloud és Oracle Cloud Infrastructure oldalán érhető el, az Azure integráció még 2026 folyamán érkezik.
Az úgynevezett last mile kapcsolat, amely irodákat, adatközpontokat és távoli helyszíneket köt az AWS-hez partnerek meglévő hálózatain keresztül.
Minden Interconnect legalább két fizikailag elkülönült helyszínen fut, független áramellátással és hálózattal, négy kapcsolatból álló redundáns modellben ECMP terheléselosztással. Ez enterprise szinten azt jelenti, hogy egyetlen eszköz vagy épület meghibásodása nem ejti ki a kapcsolatot.
Az ingyenes 500 Mbps – miért érdemes figyelni erre?
Az AWS most bevezette az ingyenes 500 Mbps-os multicloud Interconnect csomagot, amellyel a cégek tesztelhetik és élesben is futtathatják munkaterheléseiket anélkül, hogy az AWS oldalán bármilyen díjat fizetnének.
500 Mbps sávszélességgel havonta nagyjából 160 TB adat mozgatható – ez elegendő komoly multicloud munkaterhelések, adatreplikáció vagy hibrid alkalmazásarchitektúrák üzemeltetéséhez.
Fontos megérteni: az ingyenesség az AWS oldalára vonatkozik. A másik felhőszolgáltató saját maga határozza meg a díjszabást a saját infrastruktúrájára, ezért érdemes az ő árazásukat is megnézni az Interconnect létrehozása előtt. A szint régiónként és szolgáltatónként egy helyi Interconnect-re korlátozódik, és minden kapcsolat mellé egy Amazon CloudWatchNetwork Synthetic Monitor is jár külön díj nélkül – ez azt jelenti, hogy a latenciát és a csomagveszteséget folyamatosan monitorozhatod, riasztásokkal együtt.
Két valós eset, hogy érezzük a lényegét
Adatreplikáció: Egy közepes méretű pénzügyi cégnél az analitikai platform Google BigQuery-n fut, a tranzakciós rendszer viszont AWS-en. A napi szinkron eddig vagy nyilvános interneten ment – lassabban, kevésbé stabilan – vagy drága dedikált kapcsolaton. Egy 500 Mbps-os ingyenes Interconnect-tel ez privát, alacsony késleltetésű csatornán zajlik, a monitoring pedig alapból adott.
Szolgáltatás migráció: Egy vállalat Google Cloud-ról akar részben AWS-re költözni, de nem egyszerre. A két környezetnek hónapokig párhuzamosan kell futnia. Korábban ezt a hibrid fázist hálózatilag kompromisszumokkal kellett áthidalni. Most a 500 Mbps elegendő arra, hogy a migráció alatt a két oldal privát csatornán kommunikáljon, és csak akkor kell fizetős szintre lépni, ha a forgalom ezt megköveteli.
Mit érdemes tudni, mielőtt kipróbálod?
A régiós elérhetősége egyelőre korlátozott. Európában Frankfurt és London érhető el AWS–Google Cloud párban, ami a legtöbb európai vállalat számára releváns kiindulópont, de érdemes ellenőrizni, hogy a saját régiód szerepel-e a listán.
Ha az Azure az elsődleges másik felhőd, még türelem kell – az integráció az AWS közlése szerint 2026 folyamán érkezik, konkrét dátum nélkül.
Amit viszont biztosan mondani lehet: az ingyenes 500 Mbps-os szint vonzó belépési pont. Nem kell azonnal fizetős infrastruktúrában gondolkodni. Ki lehet próbálni, le lehet mérni, és csak akkor kell skálázni, ha a forgalom ezt megköveteli. Ha multicloud környezetben dolgozol, vagy csak tervezed, ez az a fajta ajánlat, amit nem érdemes figyelmen kívül hagyni.