Több hónapja olvashattok cikkeket a Kubernetesről, ahol megismerkedtünk a fürt felépítésével, és láttuk, hogyan működik együtt a vezérlősík és a munkavégző csomópontok. Olyan ez, mint amikor egy várost építünk: először megteremtjük az alapokat, majd egyre több részletet adunk hozzá. Most viszont elérkeztünk ahhoz a ponthoz, amikor a város lakói – a kapszulák – nemcsak magukban léteznek, hanem beszélniük is kell egymással.
A történet tehát itt válik igazán emberközelivé: hiába áll minden készen, ha nincs út, amin eljutunk a szomszédhoz, és hiába van házunk, ha nem tudjuk becsengetni a barátainkhoz. A Kubernetes világában ezeket az „utakat” és „kapukat” a hálózati beállítások és a szolgáltatások biztosítják.
A hálózat szerepe a Kubernetesben
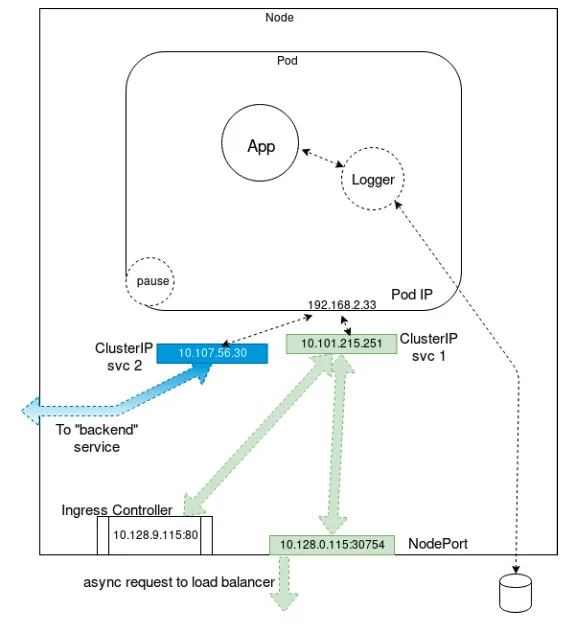
A Kubernetes egyik legfontosabb alapelve, hogy a kapszula (pod) az alap számítási egység. Egy kapszula több konténert is tartalmazhat, és ezek mind azonos IP-címet osztanak meg. Hálózati szempontból tehát egy kapszula úgy viselkedik, mint egy önálló virtuális gép vagy fizikai szerver.
Ez azonban három kihívást hoz magával, amelyeket minden fürtnek meg kell oldania:
Konténer-konténer kommunikáció ugyanazon kapszulán belül – ezt maga a kapszulázás oldja meg.
Kapszula-kapszula kommunikáció a fürt bármely csomópontján.
Külső forrás-kapszula kommunikáció, amelyet a szolgáltatások (Services) biztosítanak.
Fontos tudni, hogy a Kubernetes önmagában nem konfigurál hálózatot. A fürt üzemeltetőinek kell olyan hálózati megoldást biztosítaniuk (például CNI pluginnal), amely lehetővé teszi a kapszulák közötti közvetlen kommunikációt.
Szolgáltatások (Services) a Kubernetesben
A szolgáltatások célja, hogy stabil hálózati elérhetőséget nyújtsanak a kapszulák számára. Mivel a kapszulák dinamikusan jönnek létre és tűnhetnek el, az IP-címük is változhat. Egy szolgáltatás viszont állandó végpontot ad, amely mögé a kapszulák rendeződnek.
A legfontosabb típusok:
ClusterIP – alapértelmezett típus, amely csak a fürtön belül érhető el. Ezzel kapszula–kapszula kommunikációt tudunk megvalósítani.
NodePort – fix portot nyit minden csomóponton, amelyen keresztül kívülről elérhető a szolgáltatás.
LoadBalancer – felhőszolgáltatóknál használatos, ahol a külső terheléselosztót integrálja.
ExternalName – DNS alapú átirányítás külső szolgáltatásra.
Ezek segítségével biztosítható, hogy az alkalmazások belső és külső kliensei mindig megtalálják a működő példányokat, függetlenül attól, hogy a kapszulák IP-címe változik.
A pause container szerepe
Érdemes megemlíteni a pause konténert is, amely minden kapszulában jelen van – bár a felhasználó ezt közvetlenül nem látja. Feladata, hogy lefoglalja az IP-címet és biztosítsa a hálózati névteret, mielőtt a többi konténer elindul. Ez egy technikai részlet, de nélkülözhetetlen a kapszulák stabil működéséhez.
Kapcsolódás a külvilághoz
Amikor egy szolgáltatásnak a fürtön kívülről is elérhetőnek kell lennie, több megoldás létezik:
NodePort a legegyszerűbb, de kevésbé rugalmas megoldás.
Ingress vagy IngressController, amely HTTP(S) szintű szabályozást tesz lehetővé, és tipikusan terheléselosztással együtt használjuk.
Proxy megoldások, amelyek szintén irányíthatják a forgalmat.
Így lesz teljes a kép: a kapszulák egymással és a külvilággal is kommunikálhatnak, stabil, jól szabályozott csatornákon keresztül.
Összegzés
A Kubernetes világában a hálózat és a szolgáltatások jelentik azt az „érrendszert”, amely összeköti az életet adó szerveket. A kapszulák önmagukban csak sejtek, de a hálózat biztosítja az összhangot, a szolgáltatások pedig a megbízható híd szerepét töltik be a belső és külső világ között.
Az elmúlt időszak eseményei olyanok, mint egy mese, ami váratlanul rémálommá vált. Képzeld el, hogy van egy kis kikötő, ahol a hajók évek óta ugyanazt a megbízható szállítótól kapják az alkatrészeket, ráadásul ingyen. A kapitányok megszokták, hogy mindig időben érkezik az utánpótlás, és minden zökkenőmentesen működik. Egy nap azonban a kikötőt átveszi egy új tulajdonos, aki közli: a régi, készleten lévő alkatrészek ugyan még elérhetők, de újak már nem lesznek, legalábbis nem ingyen.
A kapitányok előtt három út marad: átállnak az új, drágább rendszerre, saját megoldást keresnek, vagy alternatív kikötőt választanak.
Technológiailag ez a helyzet tükrözi, amit néhány napja a Bitnami Docker image-k kapcsán bejelentettek. Sok fejlesztői közösség számára hirtelen egy új realitással kell szembenézni – és most megnézzük együtt, mit is jelent ez a változás, és milyen lehetőségeink vannak.
Mi az a Bitnami?
A Bitnami egy régóta ismert projekt, amely célul tűzte ki, hogy nyílt forrású szoftvereket (pl. adatbázisokat, webkiszolgálókat, cache-rendszereket) „do‐it‐yourself” egyszerűségű csomagként kínáljon: konténerképek, Helm chartok, könnyű telepíthetőség. Évtizedeken át sok Kubernetes-projekt, fejlesztő és üzemeltető használta ki előre konfigurált Bitnami image-eket és chartokat, mivel ezek stabilan, dokumentáltan és viszonylag kevés törés mellett működtek.
A Bitnami projekt most a Broadcom portfóliójába tartozik (Broadcom a VMware-t vásárolta fel), és ennek kapcsán stratégiai átalakítást hajt végre a konténerkép-disztribúciójában.
Miért fontos ez a változás?
A Bitnami eddig szerepelt sok Kubernetes infrastruktúra alapvető építőköveként: telepíthető komponensek, megbízható konténerképek, és helm chartok, amelyek akadálymentesítették az alkalmazások bevezetését. Amikor ez a támogatás visszavonul, többféle technikai és gyakorlati kockázat jelenik meg:
A docker.io/bitnami publikus regisztrációs hely (ahonnan sok image eddig szabadon letölthető volt) a változások hatására mérséklődik, és sok verziós címke eltűnik.
Az eddigi képek átkerültek egy Bitnami Legacy (bitnamilegacy) regiszterbe, ahol nem kapnak több kiadást, frissítést, biztonsági javítást.
Egy új, Bitnami Secure Images (bitnamisecure) hivatalosan nem „közösségi” szolgáltatás, hanem vállalati előfizetéshez kötött, fizetős kínálat.
A publikus Helm chartok (az OCI manifestjeik) frissítése is szünetel: a forráskód továbbra is elérhető marad GitHub-on, de az automatikus képek, verziófrissítések nem mindig jönnek majd.
A végleges “központi” publikus Bitnami regiszter törlése 2025. szeptember 29-én volt.
A Bitnami Secure Images vállalati előfizetésként érhető el, ára a források szerint több ezer dollár havonta, jellemzően 6 000 USD/hó körüli szinten indul.
Mindez azt jelenti, hogy ha nem léptünk időben, a Kubernetes klaszterekben, CI/CD folyamatokban, frissítési és automatikus skálázási műveletek során hirtelen hibaüzenetekkel (például ImagePullBackOff, ErrImagePull) találkozhatunk, amikor a rendszer nem tudja letölteni a szükséges képeket.
Mit okozhat a Kubernetes alapú rendszerekben?
Ha nem készültünk fel:
Új podok nem indulnak el – amikor a fürt új csomópontot indít vagy új replika szükséges, a rendszer letöltené a Bitnami image-t, de ha az már nem elérhető, hibát kapunk: ErrImagePull vagy ImagePullBackOff.
Frissítés vagy skálázás meghiúsul – ha egy alkalmazást új verzióra frissítenénk, de a chartban vagy a konfigurációban Bitnami image hivatkozás van, akkor az update művelet elbukhat.
Biztonsági elmaradások halmozódnak – a bitnamilegacy képek fagyottak: nem kapnak további biztonsági frissítést, így elavult, sérülékeny komponensek maradhatnak használatban.
Rejtett függőségek okozta meglepetések – nemcsak közvetlen alkalmazásaink használhatják Bitnami képeket, hanem alcsomagok, segédkonténerek, init container-ek is, amelyek rejtetten hivatkozhatnak a bitnami regiszterre.
CI/CD pipeline-ok hibái – ha build vagy teszt folyamat során Bitnami képet húzunk be (pl. adatbázis konténer, migrációs konténer), akkor az egész pipeline leállhat.
Összességében tehát egy jól működő rendszerben sok esetben „hallgatólagos” függőségek fognak megbukni, és váratlan leállások vagy hibák léphetnek fel.
Milyen lehetőségeink vannak a problémák megoldására?
Ahogy a halász a történetben új kikötőt vagy hajót választhat, nekünk is több stratégiánk van:
1. Átirányítás a Bitnami Legacy Registry (bitnamilegacy)
Ez a legegyszerűbb ideiglenes megoldás: módosítjuk a konfigurációkat (helm values, deployment spec) úgy, hogy a repository: bitnamilegacy/… formát használjuk, és tartsuk meg a jelenlegi címkéket, amíg át tudunk térni.
Előny: viszonylag kevés munkával elérhető átmeneti működés. Hátrány: ezek az image-ek nem kapnak új frissítéseket vagy biztonsági javításokat — idővel elavultak lesznek.
Ha ezt választjuk, erősen ajánlott saját privát regiszterbe tükrözni (mirror), hogy legalább ne függjünk harmadik féltől.
2. Használjuk a Bitnami Secure Images (BSI) szolgáltatást
A Bitnami bejelentette, hogy új, „secure”, hardened képek és Helm chartok szolgáltatása indul, amely verziókezelést, SBOM-ot, CVE-transzparenciát, és egyéb vállalati tulajdonságokat ad. Ez a megoldás azonban jellemzően fizetős, és inkább vállalati környezetekben lesz értelmes választás. Ha előfizetünk, akkor a képek és chartok publikusan már nem a bitnami regiszteren lesznek, hanem automatikus privát vagy dedikált OCI regisztereken. A Bitnami beígérte, hogy a Secure Images kínálat kisebb, de biztonságosabb verziókat fog tartalmazni (distroless képek, kisebb támadási felület).
3. Teljes elszakadás a Bitnami képektől – alternatívák és saját build
Ez a leginkább javasolt hosszú távon: magunknak választunk más képeket (például hivatalos Docker képeket, más közösségi projektek képeit), vagy akár a Bitnami számára elérhető open source konténerforrásokból saját képeket építünk és menedzselünk.
A Bitnami-forráskódok (Dockerfile-ok, Helm chartok) továbbra is elérhetők GitHubon Apache 2 licenccel — tehát jogilag megengedett saját építésre.
Kiválaszthatunk megbízható, aktív közösségű alternatívákat (pl. hivatalos image-ek, distro-specifikus build-ek).
Szükség lehet az értékek és beállítások átalakítására, mert nem minden image viselkedik ugyanúgy, mint a korábbi Bitnami verziók.
Célszerű bevezetni folyamatos integrációs (CI) pipeline-ban a képek tesztelését, vulnerability scan-t, hogy újabb függőségi hibák ne csússzanak be.
Lépésként részleges migráció is szóba jöhet: először a kritikus komponenseket „lecsupaszított”, alternatív képekkel cserélni, majd haladni tovább.
4. Audit és függőségek feltérképezése
Mielőtt döntenénk, célszerű átfogó auditot végezni:
Kikeresni az összes konténerkép-hivatkozást (pl. grep bitnami a manifestekben).
Megszámolni azokat a fürtön belüli podokat, amelyek Bitnami képet használnak (pl. kubectl get pods -A -o json | jq … | grep bitnami)
Felmérni, mely komponensek kritikusak, melyek kevésbé veszélyeztetettek, hogy prioritásokat állíthassunk.
Tesztelni a migrált konfigurációkat staging környezetben, hogy ne érjen minket meglepetés élesben.
5. Fokozatos átállás, párhuzamos környezetek
Nem feltétlenül kell mindent egyszerre lecserélni. Lehet fokozatosan:
Kritikus komponensek migrálása
Tesztkörnyezetek kipróbálása
Monitorozás, visszajelzések gyűjtése
Végleges átállás
Ez csökkentheti a kockázatot, és lehetőséget ad arra, hogy közbe avatkozzunk, ha valami nem működik.
Összegzés
Ez jelentős változás a konténeres és Kubernetes-alapú rendszerek világában. Ha nem készültünk fel, akkor ImagePull hibák, skálázási problémák és biztonsági elmaradások várnak ránk.
A legbiztosabb megoldás hosszú távon az, ha függetlenedünk a Bitnami-tól: alternatív képeket használunk, saját építésű konténereket alkalmazunk, és megfelelő folyamatokat építünk be (audit, tesztelés, scanning). Addig is átmeneti megoldásként a Bitnami Legacy regiszter használata segíthet.
Az elmúlt hónapokban többször írtam már a Kubernetes fejlődéséről, arról, hogyan vált a modern alkalmazásfejlesztés egyik legfontosabb alapkövévé. Szó esett a fürtök (cluster) működéséről, a kapszulák (pod) rugalmasságáról és arról, miként segíti a technológia a cégeket digitális jelenlétük megerősítésében. Most elérkeztünk egy újabb fejezethez: nézzük meg közelebbről, mi is az a csomópont (node), amely nélkül egy Kubernetes környezet nem létezhetne.
Képzeljünk el egy várost, ahol minden ház más-más feladatot lát el. Van, amelyikben ételt főznek, másutt ruhát készítenek, máshol pedig tudást gyűjtenek. A város lakói a központi tér körül gyűlnek össze, ahol szabályok szerint szervezik a közös életet. A Kubernetes világában ez a „város” a fürt, a „házak” pedig a csomópontok – mindegyikük a maga erőforrásaival és feladataival járul hozzá a közösség működéséhez.
Mi az a csomópont?
A csomópont (node) egy olyan API objektum, amely a fürt részeként jelenik meg. Gyakorlatilag egy gépet jelent – lehet fizikai szerver vagy virtuális gép –, amely futtatja a kapszulákat. A vezérlő sík (control plane) mindig Linux alapú, a munkavégző (worker) csomópontok azonban lehetnek akár Microsoft Windows Server rendszeren is.
Minden csomópontot csak akkor lehet bevonni a fürtbe, ha a szükséges szoftverek telepítve vannak rá, és képes kommunikálni az API szerverrel. Új csomópont hozzáadására például a kubeadm join parancs szolgál, míg a vezérlő síkot a kubeadm init segítségével hozhatjuk létre.
Mi történik, ha egy csomópont „eltűnik”?
A Kubernetes folyamatosan figyeli, hogy a csomópontok rendben működnek-e. Ha az API szerver öt percen át nem tud kommunikálni a csomóponton futó kubelet-tel, a rendszer automatikusan „nem elérhetőnek” jelöli azt. Ilyenkor a kapszulák kényszerített törlése helyett azok evakuálása történik, majd később, a kapcsolat helyreállásakor újra elérhetővé válnak.
Minden csomópont objektum a kube-node-lease névtérben található. Ha teljesen el akarunk távolítani egy csomópontot a fürtből, a folyamat kétlépcsős: először a kubectl delete node <node-név> paranccsal töröljük az API szerverből, majd a kubeadm reset segítségével kitisztítjuk a fürtspecifikus adatokat. Újrafelhasználás esetén még az iptables szabályokat is érdemes eltávolítani.
Hogyan figyelhetjük az erőforrásokat?
A kubectl describe node parancs részletes képet ad a csomópont aktuális állapotáról: láthatjuk a CPU és memória kapacitást, a futó kapszulákat, valamint a kért és limitált erőforrásokat. Ez a mindennapi üzemeltetés egyik kulcseszköze, hiszen segít a tervezésben és a problémák gyors diagnosztizálásában.
Összegzés A csomópontok a Kubernetes fürt alapvető építőkövei. Nélkülük nem tudnának futni a kapszulák, és nem lenne értelmezhető maga a rendszer. A csomópontok biztosítják az erőforrásokat, és a vezérlő sík által meghatározott szabályok szerint működnek. Megértésük nélkülözhetetlen a Kubernetes működésének átlátásához.
Sokat tudunk már a Kubernetes-ről a korábbi cikkek alapján. A következő cikkekben egy egész más világba szeretnélek elkaluzolni Titeket. És mielőtt ezt megtenném, ismételjünk kicsit. Ahhoz, hogy még jobban megértsük, hogyan működik ez a konténer-orchesztrációs rendszer, érdemes újra áttekinteni a legfontosabb építőelemeket.
Alapvető felépítés
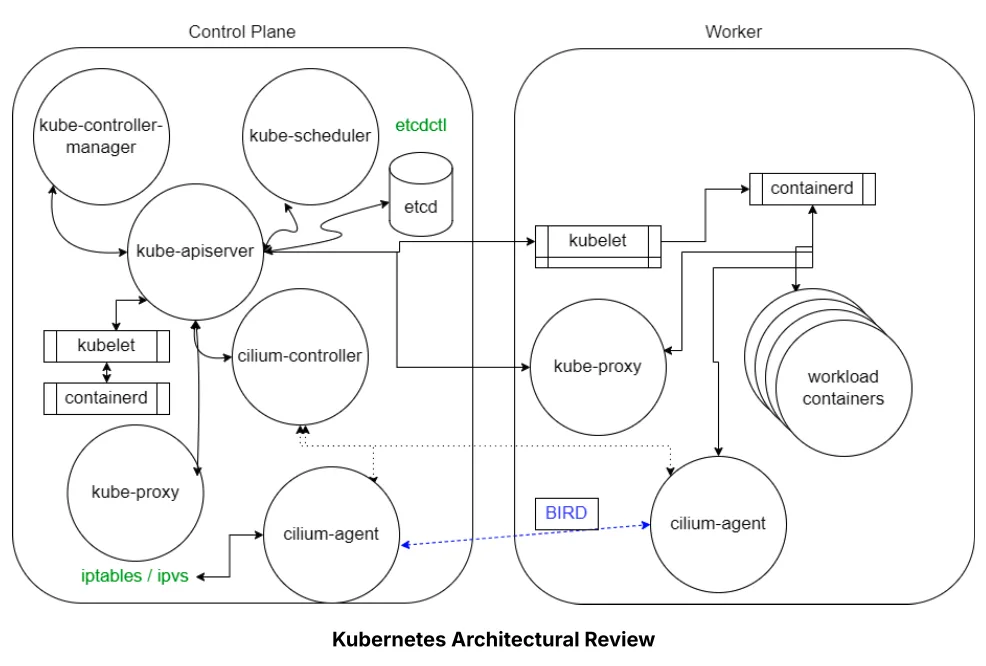
Egy Kubernetes klaszter két fő részből áll:
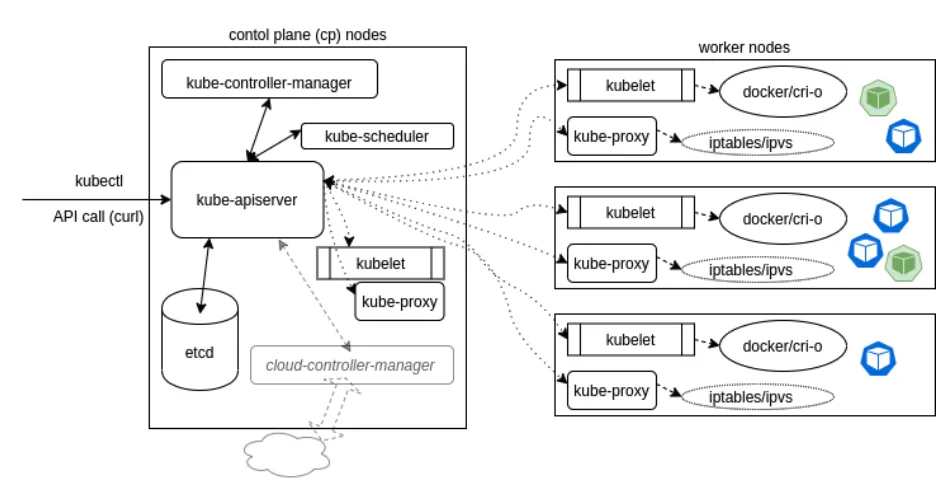
vezérlősík (control plane): itt találhatók azok a komponensek, amelyek a teljes klasztert irányítják és a döntéseket hozzák.
munkacsomópontok (worker nodes): itt futnak ténylegesen a kapszulák, vagyis a felhasználói alkalmazások és szolgáltatások.
Egy kis ismétlés
Kube-apiserver
A kube-apiserver a központi kommunikációs csatorna. Minden komponens ezen keresztül lép kapcsolatba egymással. Ez biztosítja az API felületet, amelyen keresztül a felhasználók, az adminisztrátorok és a klaszteren belüli szolgáltatások utasításokat adhatnak.
etcd
A Kubernetes állapotát és konfigurációs adatait az etcd adatbázis tárolja. Ez egy kulcs-érték alapú, nagy megbízhatóságú adattár, amely csak a kube-apiserveren keresztül érhető el. Így garantált, hogy minden állapotváltozás központilag kerül kezelésre.
Az etcdctl parancssori eszközzel lehet közvetlenül lekérdezni az adatbázist, például a fürt aktuális állapotának ellenőrzésére.
Hálózat és cilium
A Kubernetes egyik kulcskérdése a hálózat. Minden kapszulának stabil hálózati azonosítóval kell rendelkeznie, és kommunikálnia kell más kapszulákkal vagy szolgáltatásokkal.
A cilium egy hálózati plugin, amely fejlett megoldásokat kínál a hálózati forgalom irányítására, szűrésére és megfigyelésére. Segítségével jobban átláthatóvá válik, hogyan működik a kapszulák közötti hálózati kapcsolat.
Miért fontos a komponensek megértése?
A Kubernetes erőssége abban rejlik, hogy a komplex rendszert modulokra bontja. A vezérlősík komponensei biztosítják a stabilitást, a munkacsomópontok pedig a kapszulák futtatásáért felelősek. A két réteg között a kube-apiserver a „híd”, amely mindent összeköt.
Aki megérti ezeket az alapokat, sokkal könnyebben tud:
hibát keresni és elhárítani,
teljesítményt optimalizálni,
új szolgáltatásokat telepíteni,
vagy akár saját kiegészítőket fejleszteni.
Összegzés
A Kubernetes architektúra központi eleme a kube-apiserver, amely minden kommunikációt koordinál, és az etcd, amely az állapot tárolását biztosítja. Ezek köré épül a teljes rendszer, amely kapszulák futtatására, skálázására és kezelésére szolgál. A komponensek megismerése nélkülözhetetlen ahhoz, hogy magabiztosan dolgozhassunk Kubernetes környezetben.
Ma is egy Kubernetes-el foglalkozó cikket hoztam nektek. És ma is egy olyan Kubernetes szolgáltatást nézünk meg közelebbről, amely közben felhőszolgáltató specifikus is.
Azt már többször többféle módon is elmondtam, hogy a konténertechnológia forradalmasította a modern alkalmazásfejlesztést (a legismertebb konténertechnológiai megoldás a Docker): egyszerűbbé vált az alkalmazások csomagolása, szállítása és futtatása különböző környezetekben. Az Azure Kubernetes Service (AKS) ebbe a világba nyújt belépőt, méghozzá teljes mértékben menedzselt formában. A kezdők számára különösen előnyös, mert elrejti a komplexitás nagy részét, miközben erős kontrollt és rugalmasságot biztosít.
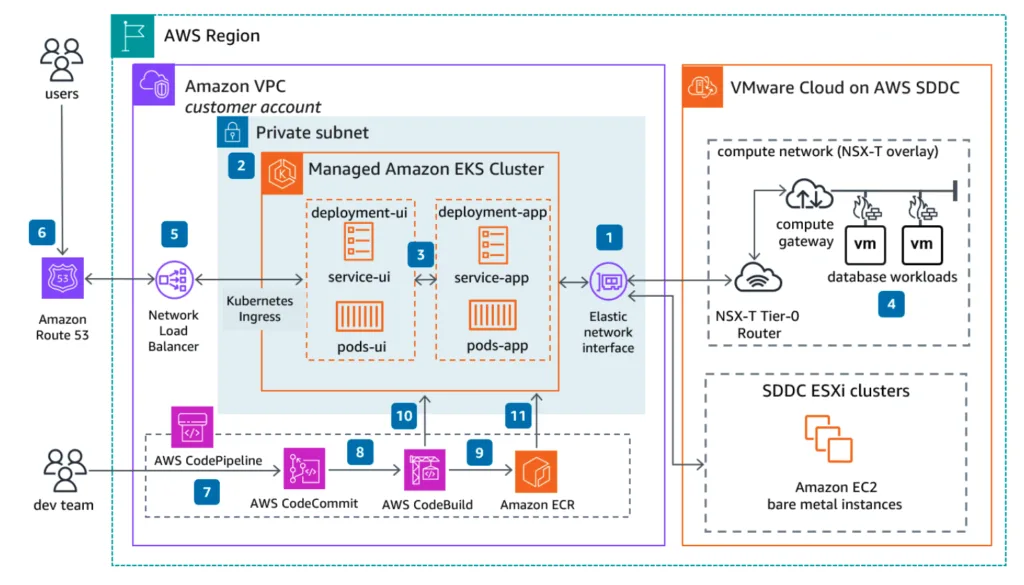
Az Amazon Elastic Kubernetes Service (EKS) egy menedzselt Kubernetes-szolgáltatás az AWS-en, amely lehetővé teszi a konténeres alkalmazások egyszerű futtatását, skálázását és biztonságos üzemeltetését. Ha modern alkalmazásokkal dolgozol, és szeretnéd kihasználni a Kubernetes nyújtotta rugalmasságot anélkül, hogy a fürtkezelés technikai részleteivel kellene foglalkoznod, az EKS ideális választás lehet.
Mi az Amazon EKS?
Az Amazon EKS a Kubernetes nyílt forráskódú rendszerét kínálja menedzselt formában. Ez azt jelenti, hogy az AWS üzemelteti a Kubernetes vezérlősíkját, így neked nem kell bajlódnod a vezérlősík (control plane) telepítésével, frissítésével, vagy a rendelkezésre állás biztosításával. Az EKS lehetővé teszi, hogy a megszokott kubectl parancsokkal és deklaratív YAML-fájlokkal dolgozz, miközben kihasználod az AWS infrastruktúra erejét.
EKS felépítése
Az EKS-ben két fő összetevővel találkozol:
Vezérlősík (control plane): Teljes mértékben az AWS kezeli. Automatikusan elérhető és hibatűrő.
Munkacsomópontok (worker nodes): Ezek az EC2 példányok (vagy Fargate egységek), amelyeken a kapszulák (pods) ténylegesen futnak.
Az EKS támogatja az EC2 alapú, Fargate alapú, vagy ezek kombinációjából álló fürtöket is, így választhatsz a teljes kontroll (EC2) vagy a szerver nélküli működés (Fargate) között.
EKS erősségei
Felügyelt Kubernetes: Nem kell telepítened vagy karbantartanod a Kubernetes vezérlő komponenseit.
Biztonság: Az AWS integráció lehetővé teszi az IAM-alapú hitelesítést és az egyéb biztonsági eszközök (pl. Secrets Manager, KMS) használatát.
Integráció más AWS szolgáltatásokkal: Könnyen összeköthető például az ELB-vel, CloudWatch-csal, vagy az IAM-mel.
Skálázhatóság: Használhatsz automatikus skálázást az EC2 Auto Scaling Group-ok vagy a Kubernetes Horizontal Pod Autoscaler révén.
Sztenderd Kubernetes: A nyílt forráskódú Kubernetes-t használja, így hordozhatóságot biztosít más környezetek felé is (pl. on-premise vagy más felhők).
EKS korlátai
Összetettebb kezdeti beállítás: A konfigurálás komplexebb lehet, mint más, egyszerűbb konténeres szolgáltatásoknál (pl. App Runner).
Költségek: Az EKS control plane külön díjat számol fel (ez nagyjából 70 EUR havonta), az EC2 példányok vagy Fargateegységek díján felül.
Tanulási idő: A Kubernetes alapjainak elsajátítása időt igényel, főként azok számára, akik most ismerkednek vele.
Mikor érdemes EKS-t használni?
Az EKS különösen akkor hasznos, ha:
Már Kubernetes-t használsz helyben vagy más felhőben, és szeretnél migrálni AWS-re.
Mikroszolgáltatás-alapú, skálázható és konténeresített alkalmazásokat futtatsz.
Fontos számodra a rugalmas, nyílt szabványokon alapuló infrastruktúra.
Nagyobb cégek számára, ahol a felhő más szolgáltatásait is ki tudja használni.
Felhasználási esetek
Tegyük fel, hogy egy SaaS alkalmazást építesz (egy több ezer felhasználót kiszolgáló webshop ahol blog is található), amelyet folyamatosan frissítened kell. Több mikroszolgáltatásból áll, ekkor az alábbiakat fogod mindenképpen használni: hitelesítés (felhasználói bejelentkezések), termékkatalógus, rendeléskezelés, hírlevelek, stb. Az EKS lehetővé teszi, hogy ezeket elkülönítve futtasd kapszulákban, frissítsd őket „rolling deployment”-el, és automatikusan skálázd a forgalom (terhelés) alapján. Közben mindezt úgy, hogy nem kell a Kubernetes fürtöd vezérlősíkját manuálisan karbantartanod.
Emellett azért is hasznos az EKS, mert az AWS többi szolgáltatásával együtt, bármilyen komplex és biztonságilag kifogástalan megoldást meg lehet vele valósítani. Például lehetővé válik az EKS integrálása a VMware Cloud on AWS-sel. Ezzel együtt használjuk az AWS DevOps eszközöket az alkalmazások modernizálásának felgyorsításához.
Ezzel csupán azt szerettem volna szemléltetni, hogy „felhőben bármi lehetséges”.
Milyen más Docker-alapú szolgáltatások érhetők el az AWS-ben?
Az AWS több más konténeres szolgáltatást is kínál, amelyekről részletesen külön cikkekben is olvashatsz:
Amazon ECS (Elastic Container Service): AWS-specifikus konténerorchesztrátor, egyszerűbb, mint Kubernetes.
AWS Fargate: Szerver nélküli konténer futtatási lehetőség, amelyet EKS-szel vagy ECS-sel kombinálhatsz.
Amazon App Runner: Egyszerű konténer-alapú webalkalmazás telepítés.
AWS Lambda (konténer támogatással): Rövid ideig futó funkciók konténer image-ből.
AWS Batch: Nagy számítási igényű kötegfeldolgozás konténerek segítségével.
Amazon Lightsail (konténer támogatással): Egyszerű, kezdőknek szánt konténeres alkalmazás hosztolás.
Összefoglalás
Az Amazon EKS azok számára ideális, akik Kubernetes-t szeretnének használni az AWS környezetében anélkül, hogy a vezérlősík üzemeltetésével bajlódnának. Robusztus, skálázható és integrálható megoldás, ugyanakkor komplexebb bevezetést igényel, mint más konténeres szolgáltatások. Ha hosszú távú, mikroszolgáltatás-alapú stratégiában gondolkodsz, az EKS megbízható alap lehet.
Ha most ismerkedsz a Kubernetes világával, az EKS tökéletes kiindulópont. Ne csak olvass róla – gyakorolj, építs, és lépj egy szinttel feljebb a felhőben!
Az elmúlt hetekben rengeteg Kubernetes-el foglalkozó cikket zúdítottam már rátok. Ez nem fog változni a közeljövőben sem, azonban ma egy olyan Kubernetes szolgáltatást nézünk meg közelebbről, amely közben felhőszolgáltató specifikus is.
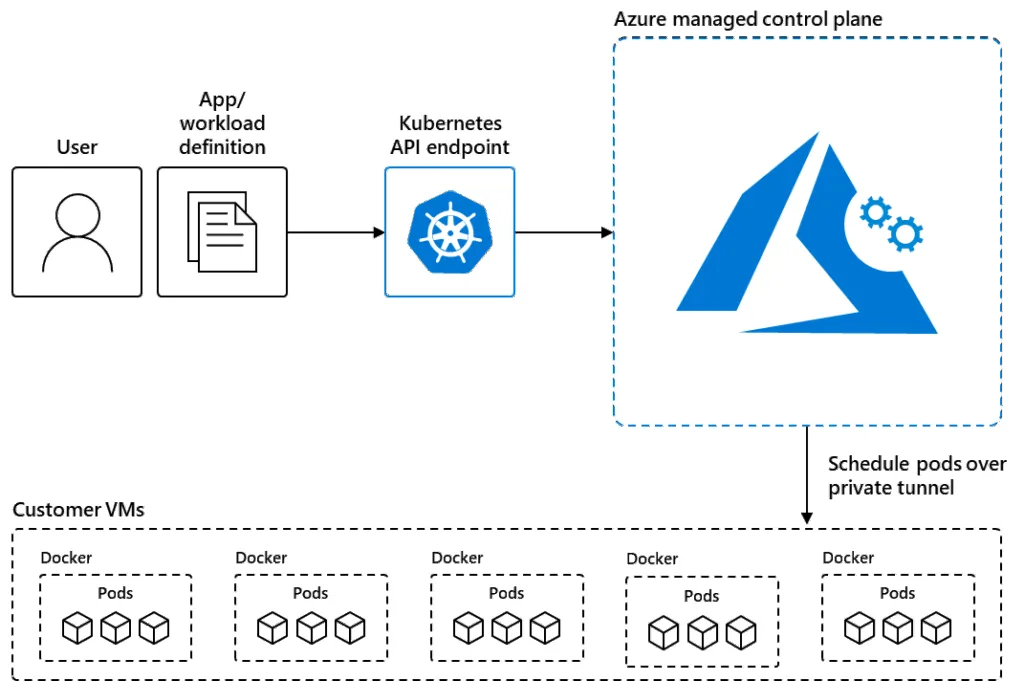
Azt már többször többféle módon is elmondtam, hogy a konténertechnológia forradalmasította a modern alkalmazásfejlesztést (a legismertebb konténertechnológiai megoldás a Docker): egyszerűbbé vált az alkalmazások csomagolása, szállítása és futtatása különböző környezetekben. Az Azure Kubernetes Service (AKS) ebbe a világba nyújt belépőt, méghozzá teljes mértékben menedzselt formában. A kezdők számára különösen előnyös, mert elrejti a komplexitás nagy részét, miközben erős kontrollt és rugalmasságot biztosít.
Mi az az Azure AKS? Az Azure Kubernetes Service (AKS) a MicrosoftAzure felhőplatformjának menedzselt Kubernetes-szolgáltatása. Lehetővé teszi konténerizált alkalmazások automatikus üzembe helyezését, kezelését, skálázását és monitorozását anélkül, hogy külön kellene gondoskodni a Kubernetes-fürt (cluster) telepítéséről és karbantartásáról.
Miért előnyös az AKS használata?
Menedzselt vezérlőréteg A Kubernetes vezérlőelemeit (control plane) teljesen menedzseli az Azure – így ezek frissítése, méretezése és biztonsági javítása nem a fejlesztőcsapat feladata.
Automatikus skálázás Támogatja a vízszintes pod-autoskalázást (HPA), node pool szintű autoskalázást, valamint a manualis skálázást is.
Integráció az Azure ökoszisztémával Könnyen integrálható más Azure szolgáltatásokkal, például Azure Monitor, Log Analytics, Key Vault, EntraID (Azure AD), vagy az Application Gateway-vel.
Támogatás Windows és Linux node poolokra Lehetőség van hibrid környezetek létrehozására is, ahol egyes szolgáltatások Windows, mások Linux konténerként futnak.
RBAC és identitáskezelés Az Azure AD integráció segítségével szabályozhatjuk, ki mit tehet a fürtben (Role-Based Access Control).
Frissítési stratégia testreszabása A cluster frissítések tervezetten, lépésenként is végrehajthatók, hogy minimalizáljuk a leállást.
Korlátok, amikkel érdemes számolni
Control Plane testreszabhatósága korlátozott Mivel menedzselt szolgáltatás, bizonyos alacsony szintű beállításokhoz nincs hozzáférés.
Sokféle beállítási lehetőség, ami összezavarhatja a kezdőket Bár a vezérlőréteg menedzselt, a node poolok, hálózatkezelés, tárolók és jogosultságok konfigurálása összetett lehet.
Hosszabb indulási idő A node poolok indulása néhány perctől akár 10-15 percig is eltarthat, főleg ha új skálázást kérünk.
Mikor érdemes az AKS-t választani? Az AKS ideális választás, ha:
Több mikroalkalmazást futtatnál egységes környezetben
DevOps pipeline-t szeretnél kiépíteni CI/CD-vel
Folyamatosan skálázódó alkalmazásokat futtatsz
Hosszú távon Kubernetes-es megközelítést szeretnél alkalmazni
Felhasználási példa: Webalkalmazás CI/CD pipeline-nal Egy több részből álló webalkalmazás (pl. frontend, backend, adatbázis) konténerizált formában van tárolva. Az alkalmazás képfájlai pedig az Azure Container Registry-ben (ACR).
Az AKS lehetővé teszi ezen konténerek fürtbe szervezését. GitHub Actions vagy Azure DevOps használatával CI/CD pipeline-t építhetünk, amely automatikusan telepíti és frissíti az alkalmazás egyes komponenseit a Kubernetes-fürtbe.
A forgalmat Azure Application Gateway vagy Ingress Controller segítségével lehet terelni, míg a logokat Azure Monitorban gyűjthetjük.
Milyen más Azure szolgáltatások támogatják még a Docker-konténereket? Bár az AKS a legteljesebb konténerkezelési megoldás, az Azure több más konténeres megoldást is kínál, amelyekről külön cikkekben olvashatsz:
Azure Arc-enabled Kubernetes: Saját Kubernetes-fürtök Azure-ból való menedzsmentje
Összefoglalás Az Azure Kubernetes Service (AKS) ideális választás azok számára, akik szeretnének skálázható, rugalmas, mikroszolgáltatás-alapú architektúrát kialakítani konténerek használatával, anélkül hogy a Kubernetes teljes komplexitásával kellene nap mint nap megküzdeniük. Az AKS lehetőséget ad a fejlődésre: kezdőként is elkezdhetjük, de haladó szintig is skálázhatjuk tudásunkat benne.
Azt azért megjegyezném, hogy egy AKS cluster fenntartása és üzemeltetése nem olcsó mulattság. Mielőtt kipróbálod, – márpedig ki kell próbálnod – ellenőrizd a díjkalkulátor segítségével, hogy mennyibe kerülne.
A Kubernetes az egyik legnépszerűbb konténer-orchesztrációs megoldás, amelyet világszerte alkalmaznak modern, skálázható és megbízható rendszerek építéséhez. A Kubernetes működésének alapját a kapszula (angolul: Pod) fogalma adja. Ez a legkisebb olyan egység, amelyet a Kubernetes kezelni tud.
Habár, mielőtt a K8s világába csöppennénk először a konténerek világával szoktunk megismerkedni. Ezen belül is a Docker szokott az első lépés lenni. Ha Te ez neked is ismerős, akkor furcsa lehet, hogy ott konténereket (angolul: container) kezelünk. Itt mégis a kapszulákat említünk.
Tehát itt nem magával a konténerrel dolgozunk közvetlenül, hanem ezzel a „kapszulázott” egységgel. Ma arról szeretnék nektek írni, hogyan működnek a kapszulák, hogyan épülnek fel, hogyan indulnak el, és hogyan segítik az init konténerek és a sidecar minták a stabil működést.
Mi az a kapszula (Pod)?
A kapszula egy vagy több konténerből áll, amelyeket egy logikai egységként kezelünk. Ezek a konténerek:
osztoznak ugyanazon IP-címen, amit a Kubernetes hozzárendelt a kapszulához,
közös tárolókat használhatnak (pl. emptyDir típusú ideiglenes fájlrendszer),
A kapszula úgy képzelhető el, mint egy konténercsoport, amely egy folyamat (pl. webalkalmazás) futtatására jött létre, és amelynek egyes részei (pl. naplózó eszköz) ugyanabban a környezetben futnak.
Egy vagy több konténer egy kapszulában?
A legtöbb esetben egy kapszula = egy alkalmazáskonténer. Ez a tiszta és egyszerű megközelítés jól működik. Azonban vannak olyan helyzetek, amikor egy kapszulán belül több konténerre van szükség:
Segédkonténer (sidecar): naplózáshoz vagy proxy-záshoz
Adapter konténer: régi interfészek kiszolgálására
Ambassador konténer: más szolgáltatások eléréséhez
Ezek a konténerek együttesen működnek, megosztják az erőforrásokat, és logikailag egy egységet képeznek. Fontos: nem különleges típusú konténerek ezek – a “sidecar” vagy “adapter” kifejezés csak szerepet jelöl, nem technikai különbséget. Tehát minden konténer ugyanúgy épül fel, csupán más szerepkört szánunk neki.
Indítási sorrend és problémák
A Kubernetes úgy lett tervezve, hogy a kapszulán belüli konténereket párhuzamosan indítsa el. Ez teljesen rendben van, ha az egyes konténerek nem függenek egymástól. De mi történik, ha egyik konténernek előbb készen kell állnia a másik előtt?
Példa:
Egy adatbázist csak akkor akarunk használni, ha már elérhető és inicializálva van.
Egy webalkalmazás csak akkor indulhat, ha a konfigurációs fájlok már betöltődtek.
Erre nyújt megoldást az init konténer.
Init konténerek: előkészítés garantált sorrenddel
Az init konténer egy olyan konténer, amely a fő alkalmazáskonténerek előtt indul el, és csak akkor indul tovább a többi konténer, ha az init konténer sikeresen befejezte a feladatát.
Tulajdonságai:
Teljesen független a fő konténerektől
Saját képpel és jogosultságokkal rendelkezhet
Ha hibásan fut, a fő konténerek nem indulnak el
Addig ismétlődik az indítás, amíg sikeresen le nem fut
Ez lehetővé teszi például, hogy:
megvárjuk egy adatbázis elérhetőségét,
végrehajtsunk fájlműveleteket vagy jogosultság-módosításokat, amelyekhez az alkalmazáskonténer nem fér hozzá.
A requests érték az a minimális erőforrás, amit a konténer igényel.
A limits érték az a maximum, amit a konténer fogyaszthat.
Ezeket az értékeket a kapszula leírásánál kell megadni, és a Kubernetes ennek megfelelően ütemezi be a kapszulát a fürt egyik csomópontjára.
ResourceQuota: névtér szintű korlátok
Ha azt szeretnénk, hogy a különböző felhasználók vagy csapatok ne lépjék túl az erőforráskeretüket, használhatunk ResourceQuota objektumokat:
Korlátozható a CPU, memória, podok, szolgáltatások, tárolók száma stb.
A scopeSelector mezővel például prioritás alapján is szabályozhatjuk a pod futtatását
Ez segít a fürt egészének stabil működésében, és megelőzi, hogy valaki túl sok erőforrást foglaljon le véletlenül vagy szándékosan.
Mit kezdjünk régi, monolitikus alkalmazásokkal?
Sok szervezetnél felmerül a kérdés: hogyan helyezzük át a régi (monolitikus) alkalmazásokat Kubernetes környezetbe?
Két megközelítés van:
Konténerizálás, ahogy van – az alkalmazás teljes egészében bekerül egy kapszulába, minimális módosítással. Gyorsabb és olcsóbb megoldás, de korlátozott rugalmasságot ad.
Újratervezés mikroszolgáltatásként – az alkalmazás komponenseit különálló kapszulákba és szolgáltatásokba bontjuk, hogy teljes mértékben kihasználjuk a Kubernetes előnyeit. Idő- és erőforrás-igényesebb, de jövőállóbb.
Egy egyszerű hasonlat:
A monolitikus alkalmazás olyan, mint egy városi busz: mindent egyszerre visz, de nem túl rugalmas.
A mikroszolgáltatás-alapú rendszer olyan, mint egy robogóflotta (pl.: Lime): kicsi, gyors, önállóan mozog, de jól kell koordinálni.
Összefoglalás
A Kubernetes kapszulái olyan, mint a konténerek futtatásának biztonságos és jól szabályozható “csomagolása”. Az init konténerek lehetőséget adnak a folyamatok sorrendjének kézben tartására, a sidecar konténerek pedig kiterjesztik az alkalmazás funkcionalitását. A precíz erőforráskezelés (limits, quota) elengedhetetlen a fürt stabil működéséhez.
Végezetül: ha régi alkalmazást szeretnél Kubernetes-be hozni, gondold át, mit nyersz a mikroszolgáltatás-alapú újratervezéssel, és hol elég a meglévő alkalmazás konténerizálása.
Az elmúlt néhány alkalommal a Kubernetes architekturális felépítéséről olvashattál. Beszéltünk a Contol Plane-ről és a Worker Node-okról. Most tovább folytatjuk utazásunkat ezen a területen.
A Kubernetes működésének megértéséhez fontos, hogy ismerjük azokat az alapvető komponenseket, amelyek a rendszer „láthatatlan motorjai”. Ebben a cikkben három ilyen kulcsszereplőt mutatok be: a kubeletet, az operátorokat és a szolgáltatásokat. Ezek együttműködése biztosítja, hogy a konténeralapú alkalmazások megbízhatóan és skálázhatóan fussanak a fürtben (cluster).
Kubelet: a node-ok gondnoka
A kubelet a worker node-okon futó ügynök, amelynek feladata, hogy végrehajtsa a fürt vezérlőkomponenseitől érkező utasításokat. Minden egyes node-on található egy példány belőle.
A kubelet főbb feladatai:
PodSpec értelmezése: Minden kapszula (pod) egy specifikáció (PodSpec) alapján jön létre. A kubelet ezt dolgozza fel, és biztosítja, hogy a node elérje a kívánt állapotot.
Hozzáférés biztosítása a kötetekhez, titkokhoz és konfigurációkhoz: Ha a kapszula igényel persistent storage-ot, Secret-et vagy ConfigMap-et, a kubelet intézi ezek elérhetőségét.
Konténer indítás: Az utasításokat továbbítja a helyi konténerfuttató motor (pl. containerd vagy CRI-O) felé.
Állapotjelentés: Folyamatosan visszajelzést küld a kube-apiservernek a kapszulák és a node állapotáról.
Erőforrás-kezelés: Egyes fejlettebb funkciók, mint például a NUMA-topológiára érzékeny CPU vagy gyorsító hardver hozzárendelés, a Topology Manager segítségével történik.
Operátorok: az automatizált felügyelők
Az operátorok – más néven kontrollerek vagy figyelő ciklusok (watch-loops) – a Kubernetes szíve-lelke. Ezek felelősek azért, hogy a fürt állapota megfeleljen a kívánt állapotnak. Minden operátor egy adott erőforrást (például Pod, Namespace, ServiceAccount) kezel.
Hogyan működnek?
Informer és cache: Az operátor egy úgynevezett Informer komponensen keresztül kérdezi le az API szervertől az erőforrás aktuális állapotát. Az adatokat cache-eli, hogy minimalizálja az API hívások számát.
DeltaFIFO: A módosításokat egy DeltaFIFO nevű sorban kezeli, és a változások (delták) alapján dönt, hogy mi a teendő.
Feldolgozás: Az operátor logikája alapján végrehajtja a szükséges lépéseket (például új kapszula létrehozása vagy meglévő módosítása).
Workqueue: A különböző feladatokat munkamenet-sorokon keresztül osztja szét a háttérfolyamatok között, amelyek kezelik az eseményeket.
Példák beépített operátorokra:
Endpoints operator: Kezeli a kapszulák elérési pontjait.
Deployments: A replikakészleteket (ReplicaSet) vezérli, amelyek azonos PodSpec alapján több kapszulát indítanak.
Szolgáltatás operátor: a hálózati kapcsolatok kapuőre
A Kubernetesben a kapszulák IP címei múlékonyak, így egy állandó elérési mód biztosítására van szükség. Ezt a szolgáltatások (Services) biztosítják, amelyek mögött egy speciális operátor – a szolgáltatás operátor – áll.
Feladatai:
Tartós IP-cím biztosítása: A szolgáltatás egy stabil IP-címet biztosít a mögöttes kapszulákhoz, még akkor is, ha a kapszulák újraindulnak vagy kicserélődnek.
Kapszulák összekapcsolása: A szolgáltatás operátor figyeli az endpoint operátort, hogy naprakész legyen abban, mely kapszulák tartoznak a szolgáltatáshoz.
Kommunikáció a hálózattal: Az operátor a kube-apiserveren keresztül eljuttatja a szükséges beállításokat a kube-proxy-nak és a használt hálózati pluginnak (pl. Cilium).
Hozzáférési szabályok kezelése: Meghatározza, hogy kik és milyen módon érhetik el a szolgáltatás mögött álló kapszulákat. Ez nemcsak a forgalomirányítás, hanem a biztonság szempontjából is fontos.
Összegzés
A Kubernetes belső működése több komponens összehangolt munkáján alapul. A kubelet biztosítja, hogy a node-ok megfeleljenek az elvárt állapotnak. Az operátorok figyelik a rendszer változásait, és aktívan fenntartják az erőforrások kívánt konfigurációját. A szolgáltatás operátor pedig lehetővé teszi, hogy a kapszulák hálózaton keresztül is stabilan és biztonságosan elérhetők legyenek.
E három komponens együttműködése biztosítja a Kubernetes megbízhatóságát, rugalmasságát és önjavító képességét – ezek teszik lehetővé, hogy a modern felhőalapú alkalmazások skálázhatóan és hibatűrő módon működjenek.
Legutóbb a Kubernetes agyáról olvashattál. Ez a vezérlősík, ami az a logikai réteg, amely a teljes fürt irányításáért felelős. Tehát már ismerjük azt, aki koordinálja a feladatokat. Akkor felmerül a kérdés: Ki végzi a háttérmunkát?
Ezek lesznek a worker node-ok. Ők azok, akik, szuperhősként dolgoznak értünk és az ügyefeleinkért.
A worker node szerepe
A worker node a Kubernetes fürt azon egysége, ahol ténylegesen futnak a kapszulák. Ezek a csomópontok több alapvető szolgáltatást futtatnak, amelyek biztosítják, hogy az alkalmazásaink megbízhatóan működjenek.
Minden node-on három fő komponens működik:
kubelet
A kubelet a node ügynöke. Folyamatosan kommunikál a vezérlősíkkal, és gondoskodik arról, hogy a node-on valóban azok a kapszulák fussanak, amelyeket a Kubernetes elvár. Ehhez az adott csomóponton telepített konténer futtató motorral dolgozik együtt – például containerd vagy cri-o.
kube-proxy
A kube-proxy felelős a hálózati forgalom irányításáért a kapszulák között, valamint a kívülről érkező kérések célba juttatásáért. Ezt iptables szabályokkal vagy IPVS (IP Virtual Server) segítségével végzi. Létezik egy „userspace” módja is, amelyben a proxy a szolgáltatásokat és azok végpontjait figyeli, és véletlenszerű portokon keresztül továbbítja a forgalmat.
Ezen kívül hálózati bővítmények (például a Cilium) is telepítésre kerülhetnek kapszula formájában, a választott hálózati megoldástól függően.
Konténer futtató motor
Ez a komponens végzi a konténerek konkrét futtatását a node-on. Bár a legtöbb esetben containerd vagy cri-o van használatban, a Kubernetes további motorokat is támogat, és ez a jövőben bővülhet.
Kiegészítő szolgáltatások: naplózás és metrikák
A Kubernetes alapból nem biztosít fürtszintű naplózási megoldást. Ehelyett egy másik CNCF projektet, a Fluentd-t használják sokan, amely egy egységes naplózási réteget biztosít: képes szűrni, pufferelni és továbbítani a logokat.
A metrikák (például CPU- és memóriahasználat) esetén szintén csak alapszintű támogatás érhető el a metrics-server nevű komponens révén. Komplexebb metrikákhoz sokan a Prometheus projektet integrálják.
Mi változik, ha a Kubernetes a felhőben fut?
Felügyelt node-ok vagy serverless?
A legtöbb felhőszolgáltató kínál felügyelt Kubernetes szolgáltatást (pl. EKS, AKS, GKE), ahol a node-ok indítása, frissítése, skálázása az ő rendszerük által automatizált. Emellett egyes platformok (pl. AWS Fargate, Azure Container Apps) lehetővé teszik serverless futtatást, ahol nincs is szükség konkrét node-okra: a kapszulák egy absztrakt erőforrásrétegen futnak, amelyet a platform kezel.
Amikor a Kubernetes nem saját hardveren, hanem valamilyen nyilvános felhőszolgáltatón (pl. AWS, Azure, GCP) fut, a worker node-ok feladatai technikailag hasonlók, de az üzemeltetésük, méretezésük és karbantartásuk módja jelentősen leegyszerűsödik – vagy éppen el van rejtve a felhasználó elől.
Automatikus skálázás
A felhőben könnyen alkalmazható a Cluster Autoscaler és a Horizontal Pod Autoscaler, így a worker node-ok automatikusan hozzáadhatók vagy eltávolíthatók a terhelés függvényében, anélkül hogy manuálisan kellene VM-eket kezelni.
Infrastruktúra szétválasztása
A felhőben gyakori, hogy külön választják a vezérlősíkot (pl. felügyelt, elrejtett control plane) és a worker node-okat. A vezérlősík karbantartása, magas rendelkezésre állása és frissítése a szolgáltató felelőssége, míg a workerök gyakran saját fiókban, saját szabályozással működnek.
Biztonsági integrációk
A node-ok sokkal könnyebben integrálhatók felhőspecifikus biztonsági szolgáltatásokkal, például IAM (AWS), Managed Identity (Azure), vagy Google IAM (GCP), amelyek segítségével minden kapszula hitelesített módon érheti el a felhőszolgáltatásokat.
Összefoglalás
A worker node-ok a Kubernetes rendszer szorgos hősei – akár helyben, akár a felhőben. Míg a helyi környezetekben a node-ok teljes irányítása az üzemeltető kezében van, a felhőben számos feladat automatizálttá vagy teljesen átláthatatlanná válik. Ez megkönnyíti az üzemeltetést, de egyben új típusú megértést is igényel.
A Terraform az egyik legnépszerűbb infrastruktúra mint kód (IaC) eszköz, amely lehetővé teszi, hogy kód segítségével építsünk és kezeljünk felhő- vagy helyi infrastruktúrát. Egy ilyen rendszer működésének kulcsa az úgynevezett state, vagyis az állapotfájl, amely tartalmazza, hogy milyen erőforrásokat hoztunk létre és azok milyen állapotban vannak. Az állapot tárolása mindig is központi szerepet játszott a Terraform használatában.
2025. májusában a HashiCorp bejelentette az MCP Servert (Model Context Protocol Server), amely egy új protokollal és megközelítéssel egyszerűsíti a távoli állapotkezelést.
Mi az a Terraform MCP Server?
A Terraform MCP Server egy háttérszolgáltatás, amely REST API-n keresztül biztosít állapotkezelési funkciókat a Terraform számára. Az MCP (Model Context Protocol) szabványos módot biztosít arra, hogy a Terraform CLI távoli szerveren kezelje az állapotot – olvassa, frissítse és zárolja azt, megakadályozva a versenyhelyzeteket.
Ez a megközelítés kiváltja a korábban használt, néha bonyolultan konfigurálható backendeket, például az S3 + DynamoDB kombinációt.
Hogyan működik?
A terraform init során a CLI kapcsolódik az MCP Serverhez, és regisztrálja az állapot útvonalát.
A terraform plan és apply hívások során az MCP Server biztosítja az aktuális állapotot, zárolja azt, majd a frissített állapotot eltárolja.
Az egész folyamat HTTP API-n keresztül zajlik, így jól integrálható más rendszerekkel is.
Előnyök
Egyszerűbb bevezetés: Nincs szükség felhőalapú tárolókra és külön lock mechanizmusokra.
Nyílt protokoll: Bárki írhat saját MCP-kompatibilis szervert.
Fejleszthető és tesztelhető: Lokális fejlesztési környezetben is könnyen kipróbálható.
Integrációs lehetőségek: Könnyedén monitorozható, naplózható, és jól működik DevOps pipeline-ok részeként.
Korlátok
Még új technológia: Bár stabil, éles környezetben fokozott figyelmet igényel.
Kevés implementáció: Egyelőre a HashiCorp hivatalos szervere az egyetlen széles körben elérhető változat.
Bevezetéshez tanulás szükséges: Másképp működik, mint a korábbi, megszokott backend-ek.
Felhasználási példa: Helyi laborkörnyezet állapotkezelése
Tegyük fel, hogy DevOps mérnökként több Terraform projektet futtatsz egyetlen gépen. Nem akarsz minden alkalommal külön S3 bucket-et vagy felhő backend-et beállítani. Egy egyszerű, saját gépen futó MCP Server lehetővé teszi, hogy a projekteket biztonságosan, de mégis helyileg kezeld. Nincs szükség internet kapcsolatra vagy hitelesítő adatok konfigurálására – csak elindítod a szervert, és használod.
Hogyan lehet kipróbálni?
Ahhoz, hogy első kézből tapasztald meg az MCP Server működését, kövesd az alábbi lépéseket:
1. MCP Server elindítása
Ha van Docker-ed, máris elindíthatod a szervert egyetlen paranccsal:
docker run -p 9701:9701 hashicorp/terraform-mcp-server:latest
Ez elindít egy konténert, amely hallgatózik a http://localhost:9701 címen. Ide fog kapcsolódni a Terraform.
2. Egy egyszerű Terraform projekt létrehozása
Készíts egy új mappát, és hozz létre benne egy main.tf fájlt például ezzel a tartalommal:
Ez a konfiguráció megmondja a Terraform-nak, hogy a state fájlt mostantól az MCP Server-en kezelje, mcp-projekt/terraform.tfstate logikai útvonallal.
3. Inicializálás és alkalmazás
A következő parancsokkal inicializálhatod és futtathatod a projektet:
terraform init
terraform apply
Mit fogsz tapasztalni?
A terraform.tfstate fájl nem jelenik meg helyben, mert az MCP Server tárolja.
A terraform apply létrehozza a hello.txt fájlt.
A konténer logjaiban látni fogod az állapotkezelési műveleteket: lock, write, unlock.
Ez egy remek lehetőség, hogy megértsd a modern state-kezelés működését – mindezt saját gépen, bármilyen felhőfiók nélkül.
Összefoglalás
A Terraform MCP Server a jövő egyik ígéretes megközelítése az állapotkezelésre. Segítségével egyszerűbbé válik a távoli state konfiguráció, különösen fejlesztői és oktatási környezetekben. A REST-alapú protokoll nyitottsága révén új integrációs lehetőségeket is megnyit, miközben a Terraform megszokott működése megmarad. Ebből is látszik, hogy az MCP nem csupán a mesterséges intelligenciában lehet hasznos.
Ha szeretnél megszabadulni a bonyolult backend konfigurációktól, ugyanakkor biztonságosan és szabályozottan kezelni az állapotokat – próbáld ki az MCP Servert.
Kiváló kiindulópont lehet saját fejlesztésű megoldásokhoz vagy modern Terraform platformok kiépítéséhez.