Van egy jól ismert kompromisszum, amivel container image alapú Lambda függvényeknél rendszeresen találkozhatunk. Ha valaki a Lambda kódját Docker image formában csomagolja – mert így illeszkedik a meglévő deployment gyakorlatához, vagy mert a függőségek mérete ezt indokolttá teszi -, akkor valamivel lassabb indulásra számíthat. Nem drámai várakozásról van szó, nem percekig tartó töltésről, hanem néhány másodperces különbségről, de ez bizonyos esetekben számít. Például egy interaktív API-nál vagy AI modellek kiszolgálásánál van jelentősége, mert ott a felhasználó valóban érzi a különbséget.
Ez a kompromisszum most kisebb lett hála a SnapStart funkciónak.
Mi változott pontosan
AWS 2026 szeptemberében elején jelentette be, hogy a Lambda SnapStart funkció mostantól container image formában csomagolt függvényekhez is elérhető. Korábban a SnapStart kizárólag a natív, zip alapú futtatókörnyezeteknél működött Python, .NET és Java esetén. A container image használat – amit sokan pont a nagyobb rugalmasság vagy a nagyobb méretkorlát miatt választanak – eddig kimaradt ebből.
Hogyan működik a SnapStart
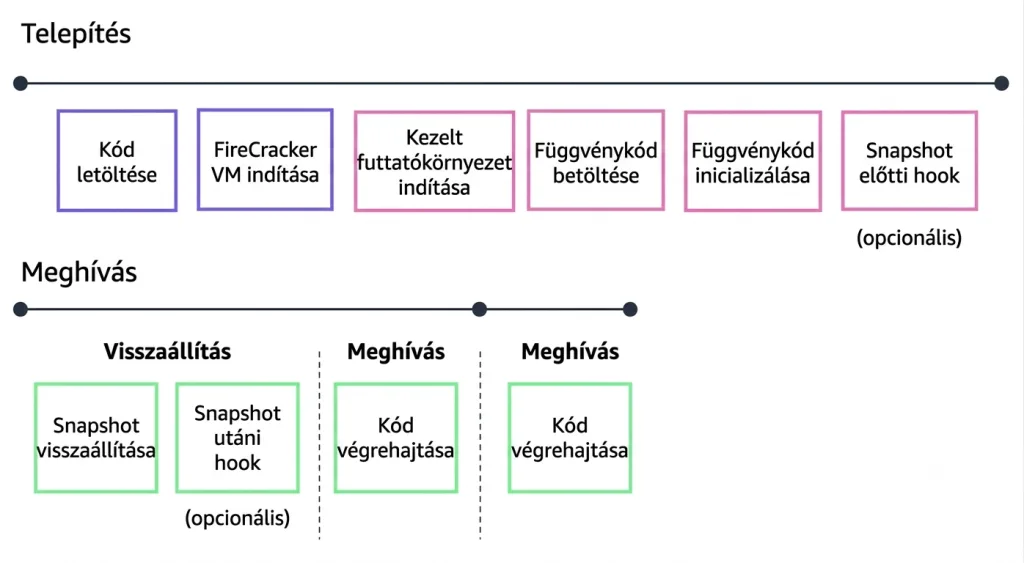
A SnapStart működése röviden így foglalható össze: A deployment (telepítés) időpontjában AWS elkészít egy pillanatképet a már előkészített futási környezetről, és ezt gyorsítótárba helyezi. Amikor egy hívás érkezik, Lambda nem nulláról indítja újra a runtime-ot és az alkalmazáskódot, hanem ebből a mentett állapotból folytatja. A gyakorlatban ez azt jelenti, hogy a néhány másodperces hidegindítási idő szinte nullára csökkenhet.
Hol érezhető a valódi különbség
A leginkább érintett terület a késleltetésre érzékeny felhasználási esetek köre: gépi tanulási modellek kiszolgálása, vagy olyan interaktív API-ok, amelyeknél a felhasználó valós időben vár válaszra. Ha egy szervezet eddig kifejezetten emiatt kerülte a container image használatát, és inkább zip formátumot használt (jóval merevebben, de gyorsabb indulással), mostantól már nem kell választania a kettő között.
Amire érdemes figyelni SnapStart esetén
A funkció aktiválása opcionális, és AWS Console, CLI, CloudFormation, SAM, SDK vagy CDK segítségével is bekapcsolható. Van azonban két dolog, amit érdemes előre tisztázni.
Nem minden AWS régióban érhető el egységesen, ezt régiónként ellenőrizni kell mielőtt használatba szeretnénk venni.
A felhasználói élmény attól is függ, milyen alap képet (base image) használunk: Java, Python és .NET esetén az újabb verziókkal ugyanúgy működik, mint a zip alapú függvényekével, míg más base image-eknél vagy egyedi image-eknél külön beállítások alkalmazás lehet szükséges (Pl.: runtime hook).
A SnapStart-nak emellett saját, külön árazási koncepciója van, amit érdemes megnézni, mielőtt bekapcsoljuk éles környezetben.
Nem mindenhol hatékony
A „kapcsoljuk be mindenhol, biztos jó lesz” hozzáállás elsőre jól hangzik. Azonban egy ilyen funkciónál pont az a lényeg, hogy célzottan alkalmazzuk. Ahol van értelme, azaz a „hidegindítás” ténylegesen felhasználói élményt vagy SLA-t befolyásol, nem pedig minden egyes függvénynél alapból. Aki csak azért kapcsolja be, mert elérhető, az extra komplexitást és valószínűleg extra költséget is behoz az eddigi működésbe.
A container image alapú Lambda funkciók eddig is jó választás voltak ott, ahol a csapat méret vagy standardizálás miatt ragaszkodott hozzá. Most ehhez a rugalmassághoz egy komoly indulási sebességbeli hátrány is megszűnt, ami a serverless architektúrák érettségét mutatja. Ez nem forradalmi újdonság, inkább egy hiányzó láncszem pótlása – de pont az ilyen apróságok a legszükségesebbek, amikor robosztus és kifinomult rendszert tervezünk.
Korábban már írtam olyan kiemelten fontos Kubernetes témáról, mint: hogyan kapcsolódnak a Pod-ok a Volume-okhoz, mire jó a PersistentVolume és a PersistentVolumeClaim, és hogyan automatizálja ezt a StorageClass a Dynamic Provisioning-on keresztül. Legutóbb pedig a Secret és a ConfigMap rejtelmeibe avattalak be Titeket. Most nézzünk egy másik alapvető fogalmat, ami nélkül a Kubernetes cluster gyakorlatilag használhatatlan lenne: a Service-eket.
Miért van szükség a Service-re?
A Kubernetes architektúrája arra épül, hogy a Pod-ok ideiglenesek. Bármelyik Pod bármikor megszűnhet, és egy újjal helyettesítődik – más IP-vel. Ha egy alkalmazás közvetlenül egy Pod IP-jére hivatkozna, minden újraindításnál elromlana a kapcsolat. A
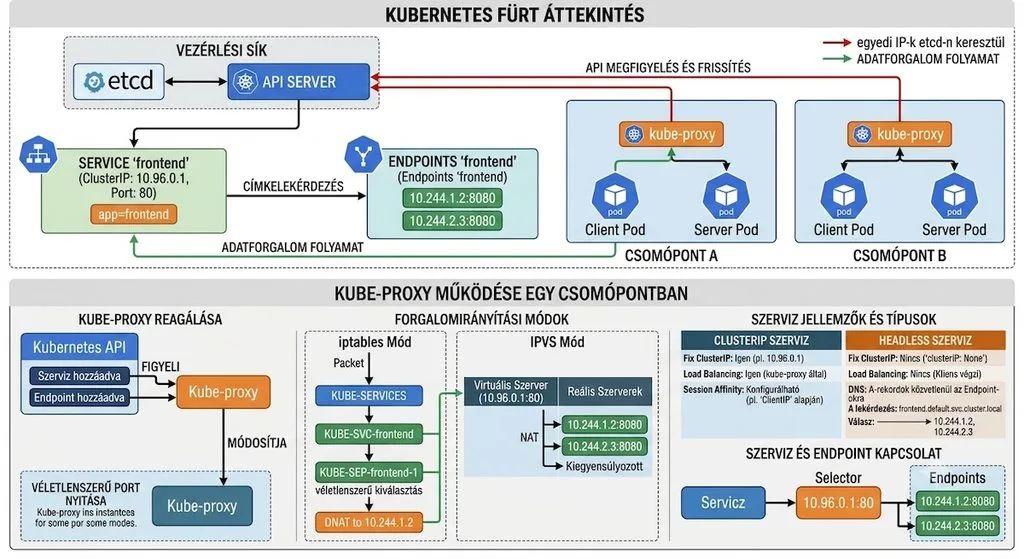
pontosan ezt a problémát oldja meg: label-ek (címkék) alapján összeköti a Pod-okat egymással, vagy elérhetővé teszi őket a cluster-en kívülről is. Amikor egy Pod lecserélésre kerül, a Service – egy Endpoint objektumon keresztül – automatikusan az új Pod-hoz irányítja a forgalmat.
Hogyan irányítja a forgalmat a kube-proxy
A háttérben a kube-proxy figyeli a Kubernetes API-t, és minden node-on reagál az új Service-ekre és Endpoint-okra. Véletlenszerű portokat nyit, figyeli a forgalmat a ClusterIP:Port címen, és onnan irányítja tovább a generált endpoint-okhoz. A Service automatikus load balancingot biztosít a label query alapján, session affinity IP alapján konfigurálható, és létezik úgynevezett headless service is, amelynek nincs fix IP-je és load balancingja. Az egyedi IP-ket a Service-ek az etcd adatbázison keresztül kapják, a forgalomirányítást pedig jellemzően iptables vagy ipvs végzi.
A négy alapvető típus
Típus
Mire jó
ClusterIP
Alapértelmezett típus, csak belső elérést biztosít a cluster-en belül
NodePort
Debugoláshoz vagy statikus IP-hez hasznos, például tűzfalon átengedett porthoz
LoadBalancer
A cloud provider (pl. GKE, AWS) felé küld kérést egy load balancer létrehozására
ExternalName
Nincs selectora, se portja – DNS szinten ad vissza egy aliast egy külső erőforráshoz
Fontos tisztázni egy gyakori félreértést: a LoadBalancer típus önmagában nem hoz létre load balancert. Először egy NodePort-ot készít, majd aszinkron kérést küld a load balancer létrehozására. Ha van olyan komponens, ami reagál erre a kérésre – ahogy ez publikus cloud környezetben történik –, akkor létrejön a load balancer. Ha nincs ilyen figyelő komponens, a Service állapota Pending marad.
Hogyan frissül egy Service működés közben
A label-ek (címkék) határozzák meg, mely Pod-ok kapják meg a forgalmat egy Service-től. Az alapértelmezett frissítési minta a rolling deployment: az új verziójú Pod-ok bekerülnek, és az automatikus load balancing miatt a régi verzióval együtt kapnak forgalmat. Ha a különböző verziók nem kompatibilisek egymással, érdemes verziószámot is tartalmazó, specifikusabb label-t használni a deploymenthez. Amikor a deployment létrehozza az új replicaSet-et a frissítéshez, a label nem fog egyezni – így csak azután áll át rá a forgalom, hogy manuálisan módosítjuk, mihez kapcsolódjon a Service. Ez minimalizálja a verziók közötti összezavarodást a kliens oldalon.
Egy példán keresztül
A leggyorsabb módja annak, hogy egy meglévő deploymenthez Service-t rendeljünk, a kubectl expose parancs:
kubectl expose deployment/nginx --port=80 --type=NodePort
kubectl get svc
Ez létrehoz egy Service-t, amely a 80-as portot használja, és véletlenszerű portot generál minden node-on. A port és a targetPort explicit is megadható, ha nem szeretnénk véletlenszerű értékeket – a targetPort alapból megegyezik a porttal, de akár egy Pod-on belüli port nevére is hivatkozhat.
DNS és a Service-ek
A CoreDNS az alapértelmezett DNS megoldás v1.13 óta. Induláskor egy szervert futtat a konfigurált zónákhoz, és plugin láncokat tölt be a további funkciókhoz – a beépített, körülbelül harminc plugin fedi le a leggyakoribb igényeket, például metrikák szolgáltatását Prometheus felé, hibalogolást vagy TLS tanúsítványkezelést. A klienseknek a kube-dns service-en keresztül van elérésük ehhez. Ha a DNS regisztrációt szeretnénk ellenőrizni, a legegyszerűbb módszer egy shell-t és hálózati eszközöket (nslookup, dig, nc) tartalmazó Pod indítása, majd a Service-en keresztüli lekérdezés – a /etc/resolv.conf fájl, a label-ek, a selector-ok és a Network Policy-k is befolyásolhatják az eredményt.
Amit szándékosan kihagytunk
Ebben a cikkben nem tértünk ki az Ingress controllerre, ami külön, a szolgáltatásokra épülő komponens, és a forgalmat URL alapján irányítja a megfelelő Service felé – ez önálló témát érdemel. Szintén nem foglalkoztunk a monitoringgal vagy a high availability beállításokkal, mert ezek külön réteget jelentenek a Service-ek alapműködése fölött.
Amire érdemes figyelni
Azure, AWS, Google Cloud és általában a felhőszolgáltatóknál a LoadBalancer típusú Service-eknél sokan elfelejtik, hogy ez valódi, fizetős cloud erőforrást hoz létre a háttérben. Teszteléskor könnyű több ilyen Service-t is létrehozni, majd elfeledkezni róluk – ez ugyanolyan felesleges költséget generál, mint egy éjszakára bekapcsolva hagyott fejlesztői VM. Érdemes rendszeresen átnézni, mely Service-ek futnak LoadBalancer típussal, és amelyikre nincs szükség, azt törölni.
Folytassuk ezt a területet azzal, hogy hogyan lehet magát a storage-ot automatizáltan orchestrálni a cluster-en belül, illetve hogyan jusson el biztonságosan a konfigurációs adat, legyen az bizalmas vagy sem, a container-ekhez.
Storage orchestration Rookkal
Amikor egy adott storage backendet, például egy Ceph cluster-t kellene kézzel telepíteni és karbantartani minden egyes Kubernetes cluster mellett, az gyorsan sok manuális munkává válik. Erre ad megoldást a Rook projekt, amely a cloud native világ decoupled és distributed jellegéhez igazodva teszi lehetővé a storage orchestration-t több különböző storage provider felett.
A Rook ugyanúgy CRD-ket, azaz custom resource definition-öket és egy custom operatort használ, mint a Kubernetes más agentjei: az operator API hívás alapján, a mögöttes storage típusának megfelelően provisionálja a tárhelyet. Több storage provider is támogatott, köztük a Ceph, a Cassandra és a Network File System, vagyis NFS.
Secrets: amikor az adatot nem szabad nyílt szemmel olvasni
A Volume-ok jól működnek helyi adatok eléréséhez, de van olyan adat, amit nem szeretnél nyílt szöveggel olvashatóvá tenni. Egy jelszó tipikus példa erre. Erre a célra való a Secret API resource.
Egy Secret manuálisan vagy a kubectl create secret paranccsal is létrehozható:
kubectl create secret generic mysql --from-literal=password=root
Fontos tudni, hogy egy Secret alapértelmezetten nincs titkosítva, csak base64-encodolva van. Ahhoz, hogy tényleges titkosítást kapj, létre kell hoznod egy EncryptionConfiguration objektumot egy kulccsal és a megfelelő identity-vel, majd a kube-apiserver-nek meg kell adni a --encryption-provider-config flaget, amely egy korábban konfigurált providerre mutat, például aescbc-re vagy kms-re. Ha ezt bekapcsolod, minden meglévő Secretet újra kell létrehoznod, mert azok csak írás közben lesznek titkosítva.
Több kulcs is megadható egyszerre. Dekódoláskor minden provider minden kulcsát megpróbálja a rendszer, de titkosításhoz mindig az első provider első kulcsa lesz használva. Kulcs rotációhoz először egy új kulcsot kell létrehozni, majd újra kell indítani az összes kube-apiserver processzt, végül minden Secretet újra kell létrehozni.
A kubectl paranccsal megnézhető a Secret-ben tárolt encodolt string, amely dekódolva egy fájlba mentett stringként jelenik meg. Ez a fájl felhasználható environment variable-ként vagy egy új könyvtárban, hasonlóan ahhoz, ahogy egy Volume megjelenik.
A Secretek számára nincs darabszám limit, de méretben egy Secret legfeljebb 1MB lehet. Minden Secret memóriát foglal a többi API objektummal együtt, így nagyon sok Secret könnyen kimerítheti egy node memóriáját. A Secretek a node tmpfs storage-ában tárolódnak, és csak arra a node-ra kerülnek el, amelyiken az adott Pod fut. Mivel egy Pod minden Volume-ját mountolni kell, mielőtt a containerek elindulnának, a Secretnek már léteznie kell azelőtt, hogy a Pod igényelné.
Secrets mountolása Volumeként
spec:
  containers:
  - image: busybox
    command:
    - sleep
    - "3600"
    volumeMounts:
    - mountPath: /mysqlpassword
      name: mysql
    name: busy
  volumes:
  - name: mysql
    secret:
      secretName: mysql
Miután a Pod fut, a container-en belül ellenőrizhető, hogy a Secret valóban elérhető-e:
ConfigMap: hordozható konfiguráció bizalmas adat nélkül
Hasonló API resource a Secrethez a ConfigMap, azzal a különbséggel, hogy az adat nincs encodolva. Ez is a Kubernetes decoupling elvét szolgálja: egy ConfigMap segítségével a container image leválasztható a konfigurációs artifactoktól.
Az adat kulcs-érték párok halmazaként vagy akár teljes konfigurációs fájlként tárolható, bármilyen formátumban. Az adat származhat egy fájlból, egy teljes könyvtár összes fájljából, vagy akár egy literal értékből is.
Egy ConfigMap többféleképpen is felhasználható: a container environment variable-ként olvashatja az adatot egy vagy több forrásból, a benne tárolt értékek átadhatók a Pod-on belül futtatott parancsoknak, létrehozható belőle egy Volume vagy egy fájl egy Volume-on belül, adott névvel és access mode-dal, sőt akár cluster komponensek, például controllerek is használhatják.
Ha van egy config.js nevű fájlod a helyi fájlrendszereden, abból létrehozható egy ConfigMap, amely a fájl tartalmát egy data szekcióban tárolja:
Fontos, hogy a ConfigMap-nek, ugyanúgy mint a Secretnek, léteznie kell, mielőtt a Pod felhasználná, hacsak nincs optional-ként megjelölve. Emellett mindkettő egy adott namespace-hez kötött.
Mire érdemes figyeljünk
Az egyik leggyakoribb félreértés, hogy a base64 encoding valamiféle titkosítást is jelent. Nem jelent: base64-tel bárki egy egyszerű dekódolással visszaállítja az eredeti értéket, a tényleges titkosításhoz az EncryptionConfiguration és a megfelelő --encryption-provider-config beállítás szükséges a kube-apiserveren.
A másik gyakori jelenség, amikor valaki egy futó Pod-ban environment variable-ként vár frissülést egy módosított ConfigMap vagy Secret után. Egy Volume-ba mountolt ConfigMap vagy Secret idővel frissül a container-ben, de az environment variable-ként átadott érték csak a Pod újraindulása után változik, mert az érték a Pod indulásakor kerül beégetésre.
Mot nem térünk ki az RBAC-alapú hozzáférés-szabályozása a Secretek körül, sem az external secret store-okkal, például a HashiCorp Vaulttal való integrációra. Ezek fontosak lesznek, amint éles környezetben kell megtervezni a bizalmas adatok kezelését, de kezdésnek elég, ha érted, mi a különbség egy Secret és egy ConfigMap között, és hogyan jut el mindkettő a Pod-okhoz.
Összegezve
A Rook megmutatja, hogyan lehet magát a storage réteget is deklaratívan, operator alapon kezelni a cluster-en belül, míg a Secret és a ConfigMap arra ad választ, hogyan válasszuk le a konfigurációt, legyen az bizalmas vagy sem, a container image-től. Ha ezt a három fogalmat érted, és tudod, melyiket mikor érdemes használni, onnantól már csak a saját cluster-ed konkrét storage és biztonsági követelményeit kell hozzáigazítanod ehhez az alapmodellhez.
Legutóbb a KubernetesDeployments világába néztünk bele, most nézzünk egy újabb fejezetet: mi történik az adatokkal, amikor egy container vagy Pod eltűnik.
A containerek eredetileg úgy lettek megtervezve, hogy ideiglenesek, azaz transient jellegűek legyenek. Ha egy container újraindul vagy törlődik, minden benne tárolt adat elvész vele együtt. Ez remekül működik stateless alkalmazásoknál, de egy adatbázis, egy feltöltött fájl vagy egy session cache esetében ez komoly probléma. Erre a problémára ad választ a Kubernetes Volume koncepciója.
A Volume alapjai
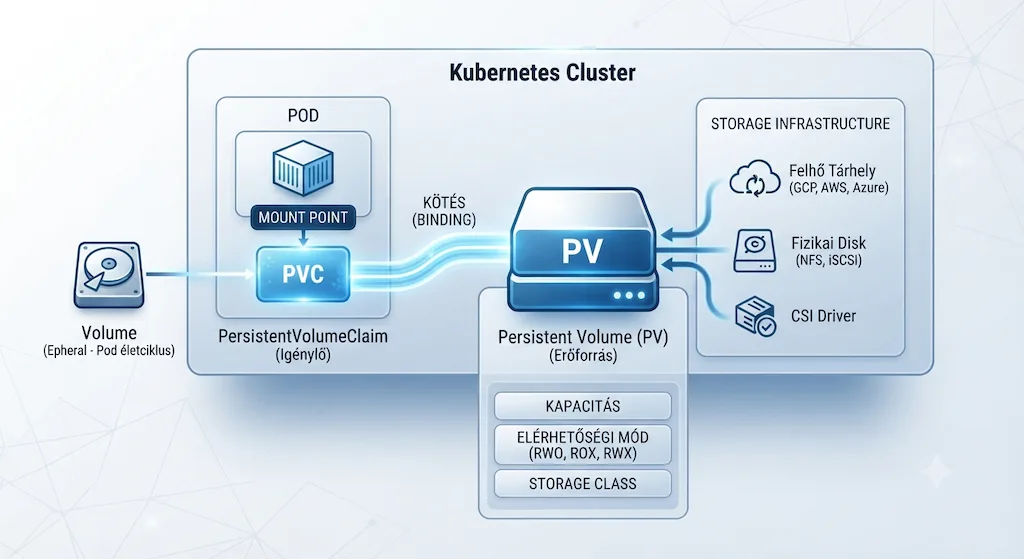
A Volume egy olyan könyvtár, amelyet a Kubernetes elérhetővé tesz a Pod konténerei számára, és amelynek élettartama a Pod élettartamához kötődik, nem az egyes konténerekéhez. Ha egy container a Pod-on belül újraindul, az adat megmarad, mert a Volume túléli a container újraindítását.
A Volume definiálásához három dolog szükséges: egy név, egy típus és egy mount point, vagyis hogy a container fájlrendszerében hol jelenjen meg. Ugyanaz a Volume több container között is megosztható egy Pod-on belül, ami praktikus container-to-container kommunikációra is használható.
A legegyszerűbb típus az emptyDir, amely egy üres könyvtárat hoz létre, és a Pod törlésekor a tartalma is eltűnik. Egy egyszerű példa:
Ez a Pod egy /cache könyvtárat hoz létre a containeren belül, amely addig él, amíg maga a Pod fut. Van még a hostPath típus is, amely a node fájlrendszeréről mountol be egy erőforrást, illetve léteznek cloud-specifikus típusok is, mint az AWS EBS, az Azure Disk vagy a GCP Persistent Disk. Ezeket ma már jellemzően a CSI, vagyis Container Storage Interface szabvány mögött érdemes elérni, mert ez teszi lehetővé, hogy a storage gyártók egységes drivereket fejlesszenek, függetlenül a Kubernetes core kódjától.
Fontos tudni, hogy a Volume-ok között nincs beépített concurrency védelem. Ha két container ugyanabba a megosztott Volume-ba ír, semmi nem védi meg őket attól, hogy felülírják egymás adatait. Ezt a Kubernetes szándékosan nem oldja meg helyetted, ezt az alkalmazás szintjén kell kezelni.
Amikor a Pod-nál tovább kell élnie az adatnak
Az emptyDir és a hostPath jó megoldás ideiglenes adatokra, de mi van, ha az adatnak túl kell élnie a Pod törlését is? Erre való a Persistent Volume, röviden PV.
A Persistent Volume egy tárolási absztrakció, amely függetlenül létezik a Pod-tól. A Pod nem közvetlenül a PV-t használja, hanem egy Persistent Volume Claim, azaz PVC objektumon keresztül igényli azt, megadva a szükséges méretet és hozzáférési módot. A cluster ezután megkeresi és hozzárendeli a megfelelő PV-t a Claim-hez.
A hozzáférési módnak három típusa van:
A ReadWriteOnce esetén egyetlen node írhatja a Volume-ot.
A ReadOnlyMany esetén több node olvashatja.
A ReadWriteMany esetén pedig több node is írhatja egyszerre.
A perzisztens tárolásnak több fázisa van:
A Provision során létrejön a PV, akár előre a cluster adminisztrátora által, akár dinamikusan a cloud provider felől.
A Bind fázisban a cluster összeköti a PVC-t egy megfelelő PV-vel.
A Use fázisban a Pod ténylegesen használja a tárhelyet.
A Release során a PVC törlésével felszabadul a kötés.
Végül a Reclaim fázis dönt arról, mi történjen az adattal: megmaradjon Retain policy mellett, törlődjön Delete policy mellett, vagy egy régebbi, ma már kivezetés alatt álló megoldásként, a Recycle töröljön mindent és váljon újra felhasználhatóvá.
Dynamic Provisioning: amikor nem kell kézzel PV-t létrehozni
Ha minden PV-t egyesével kellene manuálisan létrehozni, az gyorsan kezelhetetlenné válna egy nagyobb clusterben. Erre a problémára ad megoldást a Dynamic Provisioning: a StorageClass API objektum meghatároz egy provisionert és a hozzá tartozó paramétereket, a PVC pedig ezen keresztül automatikusan kap egy új PV-t, amikor szükség van rá.
Ez a gyakorlatban azt jelenti, hogy egy fejlesztőnek elég csak egy PVC-t igényelnie a megfelelő StorageClass-szal, és a mögöttes tárhely, legyen szó AWS EBS volumeról, Azure Disk-ről vagy GCP Persistent Diskről, automatikusan létrejön a cloud providernél.
Amire érdemes figyelni
Az egyik dolog, amit rendszeresen visszatérő jelenség, a Reclaim Policy beállítása. Ha egy PV Retain policyt kap, a mögöttes tárhely a PVC törlése után is megmarad, és tovább számlázza a cloud provider, csendben, a háttérben. Fejlesztői környezetekben ez könnyen elszabadulhat, ha senki nem takarítja el az elfelejtett PV-ket.
A másik gyakori csapda, amikor valaki ReadWriteMany hozzáférést feltételez egy olyan storage típusnál, amely csak ReadWriteOnce-t támogat. Ez általában akkor derül ki, amikor egy második Pod egy másik node-on FailedAttachVolume hibával nem tud elindulni.
Ebben a cikkben szándékosan nem tértem ki a StorageClass részletes paraméterezésére, sem a snapshot és backup stratégiákra. Ezek fontosak lesznek, amint éles, több node-os környezetben kell megtervezni a tárolást, de kezdésnek elég, ha érted az alapfogalmakat és a köztük lévő kapcsolatot.
Összegezve
A Volume, a Persistent Volume és a Persistent Volume Claim hármasa adja a Kubernetes tárolási modelljének a gerincét. Ha ezt a három fogalmat és az egymáshoz való viszonyukat érted, onnantól már csak a konkrét cloud provider driverek sajátosságait kell megismerned, és azok jellemzően jól dokumentáltak mind AWS, mind Azure, mind GCP oldalon.
Nézzünk egy újabb fejezetet a Kubernetes világából. Eddig szó volt arról, mi történik valójában egy Deployment mögött, aztán körbejártuk a workloadokat – a DaemonSeteket, StatefulSeteket és az autoscalingot -, majd a namespace-ek rendteremtő szerepét is megnéztük. A mai témám szorosan kapcsolódik mindehhez: mi történik akkor, amikor egy alkalmazás már nem egy-két manifestből áll, hanem tucatnyiból, és ezeket kell valahogy kezelhető állapotban tartani.
Ez a kérdés az utóbbi időben egyre fontosabb, ahogy egyre több AI szolgáltatás működik a Kubernetes cluster-eken is. Egy ilyen rendszer – modell-kezelő szolgáltatás, adatfeldolgozó pipeline, külső API, felügyelet – könnyen tíz-húsz külön manifestet igényel, ezek pedig gyorsan elburjánzanak, ha nincs mögöttük rendszerezettség. Erre a problémára született két, ma is aktívan használt eszköz: a Helm és a Kustomize.
Mielőtt összecsapnak a fejünk felett a hullámok
Egy éles, több komponensből álló alkalmazásnak szinte mindig van saját Deployment, Service, ConfigMap, Secret és gyakran Ingress manifestje is. Ez fejlesztői gépen még átlátható, de amint verziózni, több környezetben – fejlesztés, teszt, éles – telepíteni, majd frissíteni is kell ezeket, a kézi YAML szerkesztés hamar kezelhetetlenné és problémaforrássá válik. Ennek megoldására használjuk a két, egymástól eltérő filozófiájú eszközt a Kubernetes világában: a Helm és a Kustomize.
A Helm mint csomagkezelő
A Helm működési modellje sokat emlékeztet a hagyományos csomagkezelőkre, mint amilyen a yum vagy az apt Linux alatt. Egy Helm chart egy archivált gyűjteménye azoknak a Kubernetes manifest-eknek, amelyek együtt alkotnak egy alkalmazást. Ahelyett, hogy külön-külön kellene alkalmazni a Deployment, a Service és a ConfigMap fájlokat, a Helm ezeket egyetlen állományba csomagolja, amit egyetlen paranccsal lehet telepíteni, frissíteni vagy visszaállítani egy korábbi verzióra.
Ez a megközelítés több gyakorlati előnnyel jár. A chartok verziózhatók, tehát pontosan tudni lehet, melyik alkalmazásverzió fut a clusterben. Ha egy frissítés problémát okoz, a rollback paranccsal gyorsan vissza lehet állni egy stabil állapotra, minimalizálva a leállást és a kieséset. A konfiguráció a values.yaml fájlon vagy parancssori paramétereken keresztül környezetenként testreszabható, így ugyanaz a chart más beállításokkal futtatható fejlesztői és éles környezetben is. A Helm emellett jól illeszkedik a CI/CD folyamatokba, mögötte pedig egy aktív közösség áll, amely rengeteg előre elkészített chartot biztosít gyakori alkalmazásokhoz.
Egy tipikus chart felépítése viszonylag egyszerű logikát követ. A Chart.yaml fájl a metaadatokat tartalmazza, mint a chart neve, verziója és kulcsszavai.
apiVersion: v2
name: hello-world
description: A Helm chart for Kubernetes
type: application
version: 0.1.0
appVersion: "1.16.0"
A values.yaml azokat az alapértelmezett kulcs-érték párokat tartja, amelyeket a telepítés során lehet felülírni.
A templates mappa tartalmazza magukat a manifesteket – például egy deployment.yaml, egy svc.yaml, egy configmap.yaml vagy egy secrets.yaml fájlt -, amelyek Go templating szintaxist használnak. Ez azt jelenti, hogy a manifestekben szereplő változók, mint egy jelszó vagy egy név, a values.yaml-ból töltődnek be a telepítés pillanatában. Egy jó chart README.md fájlt is tartalmaz, amiben gyakran olyan előfeltételek szerepelnek, mint egy szükséges persistent volume megléte, ezért telepítés előtt mindig érdemes ezt átolvasni.
A chartokat repository-k tárolják, amelyek technikailag egyszerű HTTP szerverek egy index fájllal és a chartok tarballjaival. Mielőtt hozzáadnál egy repository-t, a helm search hub paranccsal az Artifact Hubon kereshetsz. Ha hozzáadtál egy repository-t, például a helm repo add paranccsal, utána a helm search repo segítségével kereshetsz benne, majd a talált chartot egyetlen helm install paranccsal telepítheted. A telepítés kimenetét mindig érdemes alaposan átnézni, mert gyakran ez tartalmazza az első nyomokat arra, ha egy szükséges cluster-erőforrás hiányzik.
A Kustomize más filozófiája
A Kustomize más utat választott. Míg a Helm templating nyelvet használ a változók behelyettesítésére, a Kustomize semmilyen sablon szintaxist nem igényel. Ehelyett egy alap, úgynevezett base konfigurációt definiálsz, majd overlay-ekkel írod felül vagy egészíted ki azt környezetenként – mondjuk a replikák számát, az image taget vagy egy címkét. A módosítások stratégiai merge és patch technikákkal történnek, nem szöveghelyettesítéssel.
Ennek gyakorlati előnye, hogy a Kustomize a kubectl része 1.14-es verziótól kezdve, tehát nincs szükség külön telepítésre – bár egy önálló bináris is elérhető, ha fejlettebb funkciókra van szükséged. A kubectl kustomize dir paranccsal megnézheted a végeredményt, a kubectl apply -k dir paranccsal pedig alkalmazhatod a clusteren.
A kustomization.yaml és a bázis-overlay felépítés
A Kustomize szíve a kustomization.yaml fájl, amely felsorolja, mely erőforrásokat kell kezelni, és milyen módosításokat kell rájuk alkalmazni. A jól szervezett projekt mappastruktúrája jellemzően egy base mappát tartalmaz a közös konfigurációval, illetve külön overlays/dev és overlays/prod mappákat a környezet-specifikus eltérésekkel, elkerülve ezzel a YAML fájlok másolgatását. A kustomization.yaml-ban beállítható például egy namePrefix, ami minden erőforrás nevéhez hozzáfűz egy előtagot – egy myapp-deployment nevű erőforrásból így lesz lf-myapp-deployment -, illetve közös címkék és annotációk is hozzáadhatók minden erőforráshoz, ami a clusteren belüli szűréshez és szervezéshez hasznos. A patchek finomhangolt, egyedi módosításokra valók, mint egy környezeti változó hozzáadása, míg a transzformerek szélesebb körű, minden erőforrásra vonatkozó módosításokat végeznek. A Kustomize emellett generátorokat is kínál ConfigMapek és Secretek dinamikus létrehozására, akár literál értékekből, akár fájlokból.
Nincs egyetlen helyes válasz. A Helm akkor kiváló választás, amikor egy alkalmazást csomagként szeretnél telepíteni, verziózni és mások számára újrafelhasználhatóvá tenni – gondolj például egy adatbázis motorra. A Kustomize akkor kényelmesebb, amikor saját, meglévő YAML fájljaidat szeretnéd környezetenként kis mértékben testre szabni, sablonok használata nélkül.
A kettő egyébként nem is zárja ki egymást: gyakori előfordul, hogy egy Helm chartot Kustomize-zal utólag testre szabnak.
Amit tapasztalatból mindenképp kiemelnék: sokan telepítenek egy közösségi chartot anélkül, hogy elolvasnák a README-t vagy átnéznék a values.yaml alapértelmezett értékeit. Ez ott szokott fájni, amikor kiderül, hogy egy alapértelmezett jelszó vagy egy nem megfelelő erőforrásigény került éles környezetbe. Ugyanígy a Kustomize overlay-eknél is érdemes tudatosan megtervezni az alap és a környezet-specifikus rétegek határát, különben pont az a rugalmasság vész el, amiért ezeket az eszközöket eredetileg bevezették: az átláthatóság és a megismételhetőség.
A tanulás fontos, és sokszor nehéz jó anyagot találni hozzá. A felhő esetén ez hatványozottan igaz, hiszen sok anyag van, de a minőségük vegyes. Az igazán jók pedig még fizetősek is. Ennek mondott ellent az AWS Cloud Quest, ahol például egy digitális világon és különböző küldetéseken keresztül barangolhatunk be egy várost, miközben megismerkedünk az AWS alap szolgáltatásaival. Ez igazán innovatív megoldás volt, ezért ajánlottam már több mentoráltamnak is.
Most pedig itt a hír: augusztus 11-én érkezik a teljesen megújult 2.0-s verzió, és az AWS Community Builder közösségben is érezhető a felfokozott hangulat körülötte.
Mi változik pontosan
A legnagyobb újdonság az úgynevezett AI Dialogue: a feladatok elején egy virtuális ügyféllel folytatsz AI-alapú beszélgetést, ahol jó kérdéseket kell feltenned, mielőtt megoldást tervezel. Ez pontosan az a gondolkodásmód, amit enterprise környezetben is elvárnak egy architect-től. Fontos, hogy ez az egyetlen pont a játékban, ahol AI-t használnak, a labor-feladatok, videók és kvízek továbbra is szakértők által összeállítottak.
Amit érdemes tudni
Kilenc szerepkör épül be, mindegyikhez saját AWS badge jár. A Cloud Practitioner és a Generative AI Practitioner ingyenes, a többi hét a Skill Builder előfizetéshez kötött. Újdonság, hogy a labor-feladatok újrajátszása mostantól az ingyenes szinten is elérhető. A meglévő játékosok badge-ei, előrehaladása és teljesített feladatai automatikusan átkerülnek, és egy welcome-back ajándék is vár rájuk.
„Save the date”
Augusztus 11. 15:00 – ekkor válik élessé az új Cloud Quest az AWS Skill Builder-en. Ha eddig csak hallottál róla, ez jó alkalom, hogy nekifuss.
Én már nagyon kíváncsi vagyok milyen lesz testközelből. Nézd meg Te is!
Néhány hete készítettem egy rövid videót azoknak, akik most ismerkednek a Google Cloud-ökoszisztémával vagy a Geminivel, mert azt tapasztalom, hogy sokan itt akadnak el már az első lépésnél. Pedig ennél egyszerűbb dolog nem is lehetne.
Az első lépések nem egyszerűek, de itt más a helyzet: az ember azt hiszi, hogy a Google AI-hoz és a Google Cloudhoz külön-külön fiókokat kell létrehoznia. Ez nem igaz. Egy meglévő Gmail-fiók pontosan elég ahhoz, hogy az egész ökoszisztémát bejárd.
Négy URL, egy fiók
A videóban négy belépési pontot mutatok meg, mindegyiket ugyanazzal az e-mail-címmel:
Ez a négy hely gyakorlatilag lefedi a Google AI és Cloud ökoszisztémájának egészét. Nincs itt semmi extra regisztráció, nincs elveszett jelszó egy külön fejlesztői fiókhoz, nincs felesleges adminisztráció.
Miért fontos ez?
Aki most vág bele a felhő vagy az AI világába, annak az első akadály gyakran nem technikai, hanem szervezési: hova is kattintsak, melyik fiókkal, melyik felületen. Ha ez az első lépés egyszerű, sokkal nagyobb eséllyel megy tovább valaki a következőre is. Ez pontosan az a simplicity-elv, amit enterprise környezetben is vallok: előbb működjön egyszerűen, utána lehet bővíteni.
Mielőtt megnézed
Ha eddig azt hitted, hogy a Google Cloud vagy a Gemini kipróbálásához külön fiókra vagy bonyolult regisztrációra van szükséged, a videó pontosan azt mutatja meg, hogy ez nem így van. Egy fiók, négy URL, és már úton is vagy a felhő és az AI világába.
Egy ideje már nem írtam cikket a Kubernetes-ről, pedig mint tudjátok szeretem ezt a témát. Amikor a Kubernetes API-ról írtam, sokan kérdezték, hogy jó, de mi történik egy deployment esetén valójában, amikor kiadunk egy kubectl apply parancsot. Most erről szeretnék írni nektek: mi zajlik a színfalak mögött, amikor egy Deployment-et létrehozunk, frissítünk, vagy éppen visszaállítunk egy korábbi verzióra.
Mi történik, amikor létrehozunk egy Deployment-et
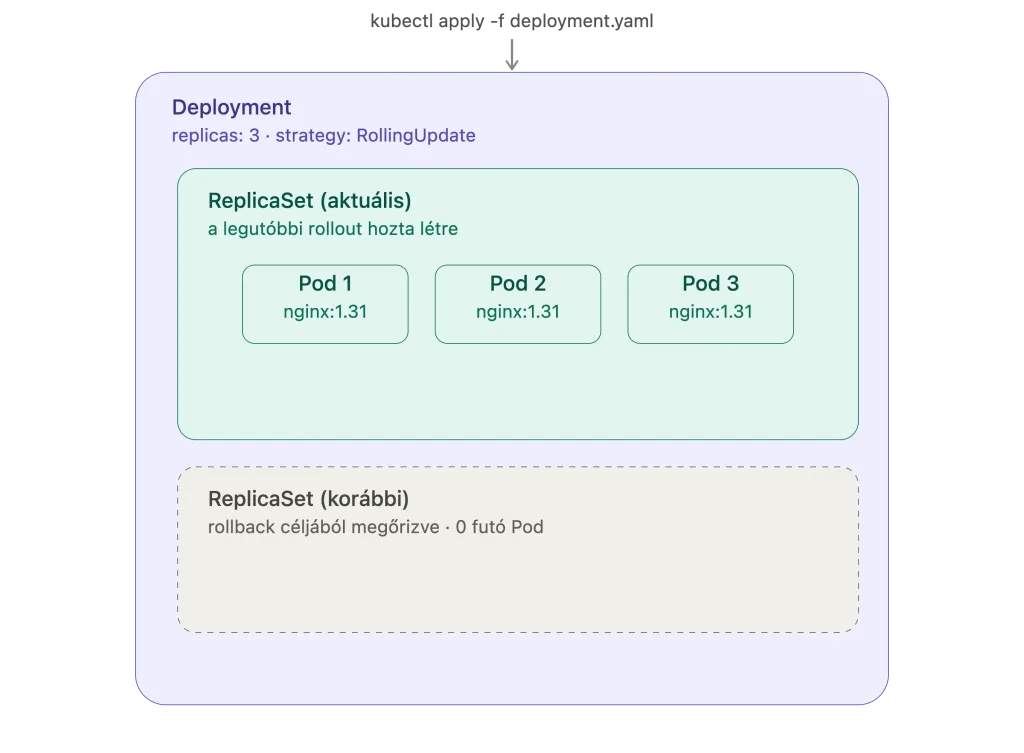
A Deployment egy YAML vagy JSON specifikációból épül fel. Amint bekerül a clusterbe, a controller automatikusan létrehoz egy ReplicaSet-et, az pedig legenerálja a Podokat. Ha egy egyszerű nginx web szervert szeretnénk futtatni, a parancs ennyi:
A rendszer válasza egyszerű visszaigazolás, hogy a deployment létrejött. Ha meg akarjuk nézni, mi került létre a háttérben, a kubectl get deployments,rs,pods -o yaml paranccsal kérhetjük le a teljes objektumfát. Én gyakran ezzel kezdek, amikor egy hibát próbálok visszakövetni, mert így látom, hogy a Deployment, a ReplicaSet és a Pod pontosan hogyan kapcsolódik egymáshoz.
Hogyan is néz ez akkor ki? Mik a fő összetevői?
A metadata blokk – mit érdemes tudni róla
Minden objektumnak van egy metadata szekciója, amiben nem a működést, hanem az azonosítást és a nyomon követést segítő adatok vannak. Itt találjuk a labeleket, az annotációkat, a létrehozás időpontját (creationTimestamp), valamint egy uid mezőt, amely az objektum egész életciklusa alatt egyedi marad. A generation mező azt mutatja, hányszor módosították az objektumot – ez praktikus, ha egy rollout történetét szeretnénk visszakövetni.
Fontos különbség, hogy az annotációk nem használhatók objektumok kiválasztására kubectl paranccsal, ellentétben a labelekkel. Ezt sokan összekeverik kezdőként, pedig a különbség lényegi: az annotáció információt hordoz, a label viszont szelekciós eszköz.
A spec – itt dől el, hogyan frissül a rendszer
A Deployment specifikációjában két külön spec blokk van: az egyik a ReplicaSet-et, a másik a Podot konfigurálja. A ReplicaSet szintű spec tartalmazza a replikák számát (replicas), a selector.matchLabels mezőt, amely meghatározza, mely Podokat tekinti a rendszer a sajátjának, valamint a frissítési stratégiát.
A strategy mező alapértelmezetten RollingUpdate, ami azt jelenti, hogy a frissítés fokozatosan történik: a maxSurge határozza meg, hány új Pod jöhet létre a régiek törlése előtt, a maxUnavailable pedig azt, hány Pod lehet átmenetileg nem elérhető. Ha ezt Recreate-re állítjuk, a rendszer előbb töröl minden meglévő Podot, és csak azután hozza létre az újakat – ez egyszerűbb, de rövid kiesést okoz.
A Pod template – a konténer tényleges beállításai
A Deployment egyik legfontosabb része a Pod template, mert ez határozza meg, milyen konténer fut valójában. Itt szerepel az image neve és verziója, az imagePullPolicy, amely azt szabályozza, mikor töltse le újra a rendszer az image-et, valamint a restartPolicy, amely biztosítja, hogy egy leállt konténer automatikusan újrainduljon.
Érdemes megjegyezni, hogy a resources mező alapértelmezetten üres. Ez azt jelenti, hogy ha nem állítunk be CPU vagy memória limitet, a konténer korlátlanul foglalhatja ezeket az erőforrásokat. Ez az egyik leggyakoribb kezdő hiba, amit én is sokszor láttam: valaki elindít egy tesztelési célú Podot limit nélkül, és napok múlva veszi észre, hogy az felzabálja a node erőforrásait.
A status – amit a rendszer visszamond
A status blokk nem konfiguráció, hanem visszajelzés. Az availableReplicas és a readyReplicas összevetésével látjuk, hogy a kívánt állapot valóban létrejött-e. A conditions mezőben szöveges üzenetek is megjelennek, például hogy a Deployment elérte a minimális elérhetőséget, vagy hogy egy új ReplicaSet sikeresen kigördült. Az observedGeneration pedig azt mutatja, hányszor követte a rendszer a konfiguráció változását – ez jó kiindulópont, ha egy rollout állapotát szeretnénk diagnosztizálni.
A replikák száma egy egyszerű paranccsal módosítható:
kubectl scale deploy/dev-web --replicas=4
Ha a replikák számát nullára állítjuk, a konténerek megszűnnek, de a Deployment és a ReplicaSet objektum megmarad – ez pontosan az, ami a háttérben történik, amikor egy Deployment-et törlünk.
Nem minden mező módosítható szabadon, egyes értékek immutable-ek, ez verziófüggő. Az image verziójának módosítása viszont mindig lehetséges, és kubectl edit deployment paranccsal élőben is elvégezhető. Egy ilyen módosítás automatikusan elindítja a rolling update-et.
Ha valami elromlik – rollback
Az egyik legmegnyugtatóbb tulajdonsága a Deployment-eknek, hogy a korábbi ReplicaSet verziók megmaradnak, így vissza lehet állítani egy működő állapotot. Ha egy image frissítés hibás verzióra mutat, és a Podok ImagePullBackOff állapotba kerülnek, a kubectl rollout undo deployment/ghost paranccsal egyszerűen visszaléphetünk. Konkrét revízióra is visszaállhatunk a --to-revision opcióval. A kubectl rollout pause és resume parancsok pedig lehetővé teszik, hogy egy rollout közepén megállítsuk, majd később folytassuk a folyamatot.
DaemonSet – amikor minden node-on kell egy Pod
A DaemonSet más logikát követ, mint a Deployment: biztosítja, hogy minden node-on pontosan egy Pod fusson ugyanazzal az image-dzsel. Ha új node kerül a clusterbe, a DaemonSet automatikusan odatelepíti a Podot, ha egy node kikerül, a Pod is törlődik vele. Ez tipikusan logolási vagy metrika-gyűjtő ügynökök esetén hasznos, ahol fontos, hogy minden node-on futnia kelljen az adott komponensnek, anélkül, hogy erről manuálisan kellene gondoskodni.
Labelek – a cluster rendezésének kulcsa
A labelek nem API objektumok, mégis a Kubernetes-alapú üzemeltetés egyik legfontosabb eszközei. Bármilyen objektumhoz rendelhetünk kulcs-érték párokat, és ezek alapján szűrhetünk, csoportosíthatunk. A kubectl get pods -l run=ghost parancs pontosan ezt teszi lehetővé. Fontos, hogy egy Deployment label selectora apps/v1 API verziótól kezdve immutable, tehát létrehozás után már nem módosítható.
A labelek gyakorlati haszna a nodeSelector alkalmazásánál a legszemléletesebb: ha egy node-hoz disktype: ssd labelt rendelünk, egy Pod specifikációjában megadhatjuk, hogy csak ilyen node-ra kerüljön ki. Ez egyszerű, de sokat elárul arról, hogy a Kubernetes tervezésekor mennyire tudatosan gondolták végig a rugalmas, ám átlátható erőforrás-kezelést.
És mi a lényeg?
A Deployment látszólag egyszerű objektum, de a mögötte húzódó réteges struktúra – metadata, spec, template, status – valójában egy jól megtervezett állapotgép. Aki most kezd Kubernetes-szel dolgozni, annak érdemes megszokni, hogy minden változás egy új ReplicaSet-et generál, és hogy a resources mező üresen hagyása előbb-utóbb kellemetlen meglepetést hoz. Ez az egyik legjellemzőbb kezdő csapda, amivel én is sokszor szembesültem: a rendszer működik, csak épp senki nem korlátozta, mennyi erőforrást használhat.
Ha valaki mélyebben szeretné megérteni ezt a réteges logikát, a managed Kubernetes szolgáltatások, mint az AzureAKS, az AWS EKS vagy a Google CloudGKE, jó kiindulópontot adnak, mert ugyanezt az alapstruktúrát használják, csak a klaszter üzemeltetését veszik le a fejlesztő kezéből.
Rendszeresen készítek videós képzéseket, és minden alkalommal ugyanazzal a kihívással szembesülök. A videók szépen ott vannak az S3-on, mappákba rendezve, de minden, ami ezen felül fontos lenne, egy külön jegyzetben van: melyik anyaghoz milyen felirat tartozik, milyen kapcsolódo linkek vannak, melyik leckéhez kell még kiegészítő információ. Ezt a jegyzetet frissítgetem, és ezt küldöm el a Mentor Klubnak minden alkalommal, amikor egy új anyag elkészül.
Az AWS most pont ebben könnyítette meg a mindennapjaim: az S3-ba egy új funkciót épített be, az annotációt, amivel ez a fajta extra kontextus nem a videó mellett, hanem magában az objektumban lehet.
Mi az annotáció?
Az S3-hoz mostantól objektumonként akár 1000 darab, egyenként 1 MB méretű, összesen 1 GB-os annotációt lehet csatolni. A formátum kötetlen: JSON, XML, YAML vagy sima szöveg is lehet. A lényeg, hogy ez nem statikus.
Bármikor módosíthatod vagy törölheted, anélkül hogy az objektumot újra kellene írni. Ha az objektum másolódik, replikálódik vagy régiók között mozog, az annotáció vele megy. Ha törlöd az objektumot, az annotáció is eltűnik vele.
Hogy viszonyul ez a korábbiakhoz?
Az S3-ban eddig is volt pár módja annak, hogy infót tegyél egy objektumra, csak mindegyiknek volt egy szűk korlátja. A system-defined metadata fix dolgokat ad, mint a méret vagy a storage class, ezt nem te írod. A user-defined metadata feltöltéskor írható, de csak 2 KB-ig, és utána már nem módosítható. Az object tag-ek jól jönnek hozzáférés-vezérléshez vagy lifecycle szabályokhoz, de korlátozott számban definiálhatók, és messze nem elég nagyok komolyabb kontextushoz.
Így néz ki ez egymás mellett:
Metaadat típus
Max méret
Módosítható?
Mire jó
System-defined metadata
Fix
Nem
Objektum tulajdonságok: méret, storage class, létrehozás ideje
Az annotáció pont azt a hiányt tölti be, amit a másik három együtt sem tud: nagy méret, rugalmas formátum, és bármikor módosítható tartalom.
Hogyan állítod be valójában?
Tegyük fel, hogy van egy videód az S3-ban, és hozzá akarod csatolni a technikai specifikációit, vagy felitaror, vagy egy linket. Készítesz egy mediainfo.json fájlt a gépeden, benne a kódolással, felbontással, hangsávok számával és minden szükséges információval. Aztán az AWS CLI-vel egyetlen paranccsal csatolod az objektumhoz:
Ha egy másik csapat ugyanerre a videóra egy AI-generált összefoglalót is rátenne, simán megteheti egy másik annotáció néven, mondjuk ai_summary alatt, anélkül hogy a mediainfo annotációhoz hozzáérne. A kettő egymástól függetlenül él, frissül, törlődik.
Ha meg akarod nézni, mi van összesen egy objektumon, a list-object-annotations parancs kilistázza az összeset, a delete-object-annotation pedig eltávolít egyet, ha már nincs rá szükség.
A lekérdezhetőség, ahol a legjobb
A valódi potenciál nem az egyedi objektumokban van, hanem abban, hogy az annotációkat egyszerre, sok ezer vagy millió objektumon át is le tudod kérdezni. Ha bekapcsolod az S3 Metadata funkciót, az annotációk automatikusan bekerülnek egy felügyelt Apache Iceberg táblába, amit Amazon Athenával lekérdezhetsz.
Egy egyszerű SQL lekérdezéssel megtalálod például az összes videót, amelynek nyolcnál több hangsávja van, anélkül hogy egyenként át kellene nézned a fájlokat. És itt jön be az agentic AI: az S3 Tables MCP szerveren keresztül egy AI agent természetes nyelven is rákérdezhet az adatokra, mondjuk hogy keresse meg az összes AWS képzésekhez tartozó videót ami AI témájú, és a válasz másodperceken belül megjön.
Ezt a fajta szétcsúszást bárki jól ismeri, még ha nem is S3 vagy videók tekintetében. Nehéz az ilyen jellegű információkat összehangolni. Persze az annotáció sem oldja ezt meg varázsütésre, de legalább segít helyre tenni a dolgokat, tehát: az információ nem egy külön fájlban, hanem magán a videón van.
Mire figyelj?
Két dologra biztosan figyelj.
Az első a jogosultság: az IAM policy-ban vagy bucket policy-ban explicit engedélyezni kell az s3:PutObjectAnnotation és s3:GetObjectAnnotation action-öket, ezek nélkül semmi nem fog működni.
A második, és ebbe szerintem sokan bele fognak futni: az annotáció tárolása mindig S3 Standard díjszabás szerint történik, függetlenül attól, hogy az alapobjektum melyik storage class-ban van. Ha archív, Glacier-ben pihenő objektumokra kezdesz el nagy, JSON-ös annotációkat pakolni csak mert lehet, simán meglepődhetsz a számlán a hónap végén. Pont az a fajta tervezés nélküli felhőhasználat ez, amitől általában óvni szoktam mindenkit.
Kinek hasznos, és kinek nem
Tudom, hogy a magyar piacon még kevés cég épít komoly multi-agent rendszereket, ezért jogos a kérdés, hogy ez most kinek szól. A válaszom: nem csak azoknak, akik már AI agenteket futtatnak élesben. Ha bármilyen S3-ban tárolt „adatvagyonod” van, médiafájlok, dokumentumok, log-ok, exportok, és eddig külön rendszerben tartottad nyilván, hogy mi van bennük, az annotáció egy egyszerűbb és olcsóbb módja annak, hogy ezt egy helyen kezeld.
Érdemes tudni, hogy az Azure Blob Storage-nak és a Google Cloud Storage-nak is van saját metadata és tag mechanizmusa, de ezek mérete és rugalmassága jellemzően jóval kisebb ennél. Az S3 annotáció abban hoz újat, hogy ilyen méretben, akár 1 GB-ig, ilyen formátum-szabadsággal, és ennyire szorosan az AI agent munkafolyamatokhoz illesztve teszi ezt elérhetővé.
Amit szándékosan nem fejtek ki most: hogyan tervezd meg az annotációk séma-struktúráját nagy skálán, hogyan optimalizáld az Athena lekérdezések költségét, vagy hogyan állítsd fel a governance modellt arra, ki írhat és törölhet annotációkat nagyvállalati környezetben. Ezek mind valós kérdések, amint egy csapat mérete megnövekszik, de ez már egy külön cikk témája lehetne.
Habár elsőre nem nagy dolog, én látom a pozitív hozadékát. Sokak életét fogja megkönnyíteni ez az apró funkció: nálam a videós képzéseknél, máshol talán egy egész csapatnál, ahol eddig külön rendszerben tartották nyilván, mi tartozik egy fájlhoz. Kis lépés, de ettől nem kisebb a haszna.
Amikor valaki felhő alapú projektet tervez, általában csak egy szolgáltatóban gondolkozik. Ez a természetes irány, és nem is meglepő – egy rendszer, egy számla, minden egy helyen. Ez az általános trend.
Pedig aki alaposan ismeri az AWS-t, az Azure-t és a Google Cloud-ot, hamar rájön: mindegyiknek vannak erősségei, és mindegyiknek vannak gyengeségei. Ha valaki engem kérdezne, hogy mi lenne egy nagy, vállalati szintű megoldás tökéletes kivitelezése, azt mondanám: mindegyikből a legjobbat használjuk. Azonban ez sajnos a legtöbb esetben nem lehetséges.
Miért ragad be mindenki egyetlen szolgáltatónál?
A válasz általában nem technikai – hanem emberi. Aki egyszer megismerte az AWS konzolt, az ott érzi magát otthon. A csapat ott szerzett tapasztalatot, azzal kapcsolatban vannak a tanúsítványok, és az architektúra is arra épül. Váltani vagy párhuzamosan üzemeltetni látszólag bonyolultabb, drágább, és több kockázattal jár.
Ehhez jön hozzá a vendor lock-in jelensége. Az iparági ajánlás egyértelmű: kerüld el, maradj hordozható, ne függj egyetlen szolgáltatótól. A valóságban azonban ez szinte lehetetlen.
Minél mélyebbre ásol egy platform saját szolgáltatásaiban – saját adatbázisok, saját AI eszközök, saját hálózati megoldások – annál inkább benne vagy. És ha egyszer erre építed az architektúrát, a váltás költsége a legtöbb esetben meghaladja a maradás kényelmetlenségét. A nagy szolgáltatók pontosan tudják ezt, és az árazásuk is ezt tükrözi. Aki már látott hosszú távú enterprise szerződést egy nagy felhőszolgáltatóval, az tudja, miről beszélek.
A multicloud lényege egyszerű: nem egy szolgáltatóban gondolkozol, hanem oda teszed a munkaterhelést, ahol az adott feladatra a legjobb eszközök vannak. Az analitika mehet Google Cloud-ra, a gépi tanulási infrastruktúra AWS-re, a Microsoft-integrációk Azure-ra.
A hybrid cloud pedig azt jelenti, hogy a saját adatközpontod és a felhő együtt dolgozik – nem vagy kénytelen mindent kiszervezni.
A valóságban persze ez sem ilyen egyszerű. Mert ha két felhő között adatot kell mozgatni, azonnal felmerül a kérdés: hogyan? A nyilvános interneten keresztül? Az lassabb, kiszámíthatatlanabb, és biztonsági szempontból sem ideális. Dedikált fizikai kapcsolattal? Az drága, lassan kivitelezhető, és komoly hálózati szaktudást igényel. Pontosan itt jön képbe az AWS Interconnect.
Mi az AWS Interconnect?
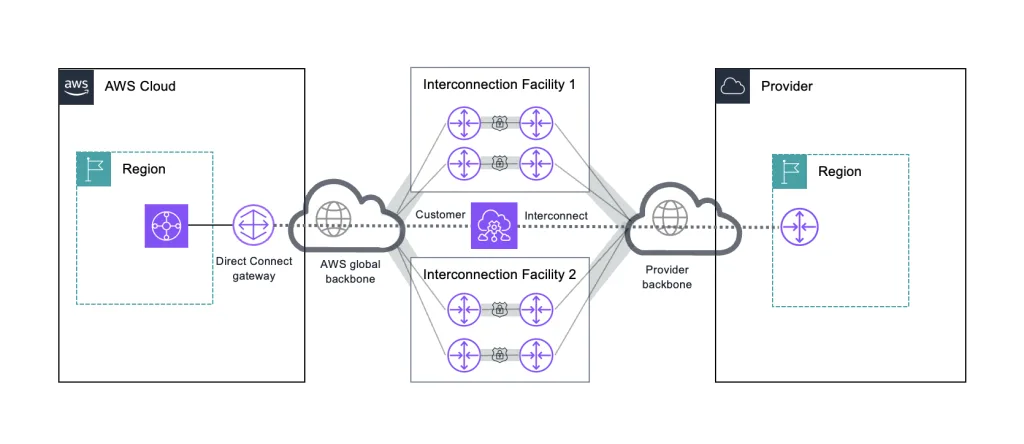
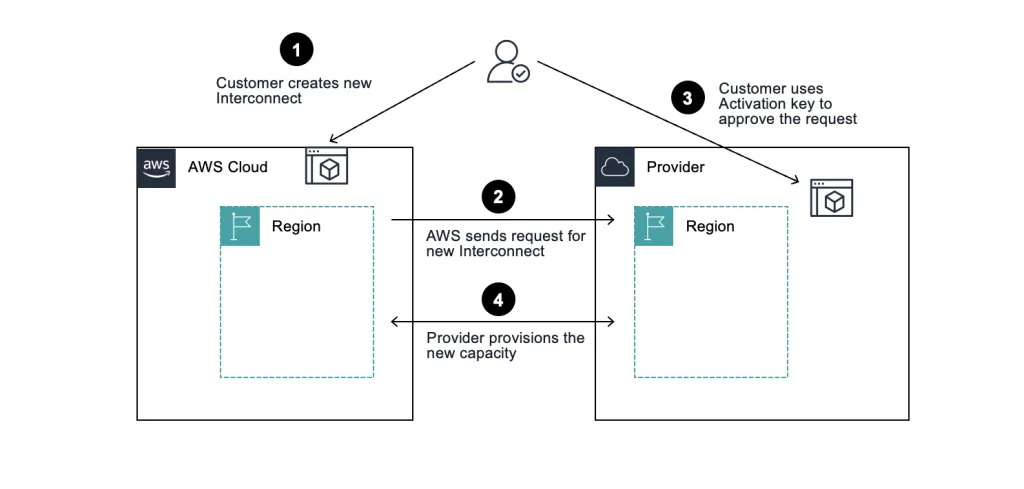
Az AWS Interconnect egy viszonylag friss szolgáltatás, amelyet pontosan erre a problémára terveztek. A hagyományos megközelítésben privát kapcsolatot létrehozni két felhő között fizikai routerek konfigurálását, BGP peering beállítást és cross-connect megrendeléseket jelentett – ez hónapokat és komoly szakértelmet igényelt. Az Interconnect ezt váltja ki.
A folyamat leegyszerűsödik: kiválasztod a régiót, a szükséges sávszélességet és a szolgáltatót, az AWS és a partner pedig percek alatt előkészíti a kapcsolatot. A felhasználó mindebből egyetlen logikai objektumot lát a konzolban – a háttérben zajló redundáns infrastruktúra, a fizikai helyszínek és az MACsec titkosítás mind el van rejtve.
A szolgáltatásnak két arca van:
A multicloud változat, amely AWS VPC-ket köt össze más felhőszolgáltatók hálózataival – jelenleg Google Cloud és Oracle Cloud Infrastructure oldalán érhető el, az Azure integráció még 2026 folyamán érkezik.
Az úgynevezett last mile kapcsolat, amely irodákat, adatközpontokat és távoli helyszíneket köt az AWS-hez partnerek meglévő hálózatain keresztül.
Minden Interconnect legalább két fizikailag elkülönült helyszínen fut, független áramellátással és hálózattal, négy kapcsolatból álló redundáns modellben ECMP terheléselosztással. Ez enterprise szinten azt jelenti, hogy egyetlen eszköz vagy épület meghibásodása nem ejti ki a kapcsolatot.
Az ingyenes 500 Mbps – miért érdemes figyelni erre?
Az AWS most bevezette az ingyenes 500 Mbps-os multicloud Interconnect csomagot, amellyel a cégek tesztelhetik és élesben is futtathatják munkaterheléseiket anélkül, hogy az AWS oldalán bármilyen díjat fizetnének.
500 Mbps sávszélességgel havonta nagyjából 160 TB adat mozgatható – ez elegendő komoly multicloud munkaterhelések, adatreplikáció vagy hibrid alkalmazásarchitektúrák üzemeltetéséhez.
Fontos megérteni: az ingyenesség az AWS oldalára vonatkozik. A másik felhőszolgáltató saját maga határozza meg a díjszabást a saját infrastruktúrájára, ezért érdemes az ő árazásukat is megnézni az Interconnect létrehozása előtt. A szint régiónként és szolgáltatónként egy helyi Interconnect-re korlátozódik, és minden kapcsolat mellé egy Amazon CloudWatchNetwork Synthetic Monitor is jár külön díj nélkül – ez azt jelenti, hogy a latenciát és a csomagveszteséget folyamatosan monitorozhatod, riasztásokkal együtt.
Két valós eset, hogy érezzük a lényegét
Adatreplikáció: Egy közepes méretű pénzügyi cégnél az analitikai platform Google BigQuery-n fut, a tranzakciós rendszer viszont AWS-en. A napi szinkron eddig vagy nyilvános interneten ment – lassabban, kevésbé stabilan – vagy drága dedikált kapcsolaton. Egy 500 Mbps-os ingyenes Interconnect-tel ez privát, alacsony késleltetésű csatornán zajlik, a monitoring pedig alapból adott.
Szolgáltatás migráció: Egy vállalat Google Cloud-ról akar részben AWS-re költözni, de nem egyszerre. A két környezetnek hónapokig párhuzamosan kell futnia. Korábban ezt a hibrid fázist hálózatilag kompromisszumokkal kellett áthidalni. Most a 500 Mbps elegendő arra, hogy a migráció alatt a két oldal privát csatornán kommunikáljon, és csak akkor kell fizetős szintre lépni, ha a forgalom ezt megköveteli.
Mit érdemes tudni, mielőtt kipróbálod?
A régiós elérhetősége egyelőre korlátozott. Európában Frankfurt és London érhető el AWS–Google Cloud párban, ami a legtöbb európai vállalat számára releváns kiindulópont, de érdemes ellenőrizni, hogy a saját régiód szerepel-e a listán.
Ha az Azure az elsődleges másik felhőd, még türelem kell – az integráció az AWS közlése szerint 2026 folyamán érkezik, konkrét dátum nélkül.
Amit viszont biztosan mondani lehet: az ingyenes 500 Mbps-os szint vonzó belépési pont. Nem kell azonnal fizetős infrastruktúrában gondolkodni. Ki lehet próbálni, le lehet mérni, és csak akkor kell skálázni, ha a forgalom ezt megköveteli. Ha multicloud környezetben dolgozol, vagy csak tervezed, ez az a fajta ajánlat, amit nem érdemes figyelmen kívül hagyni.